串
串的定义与实现
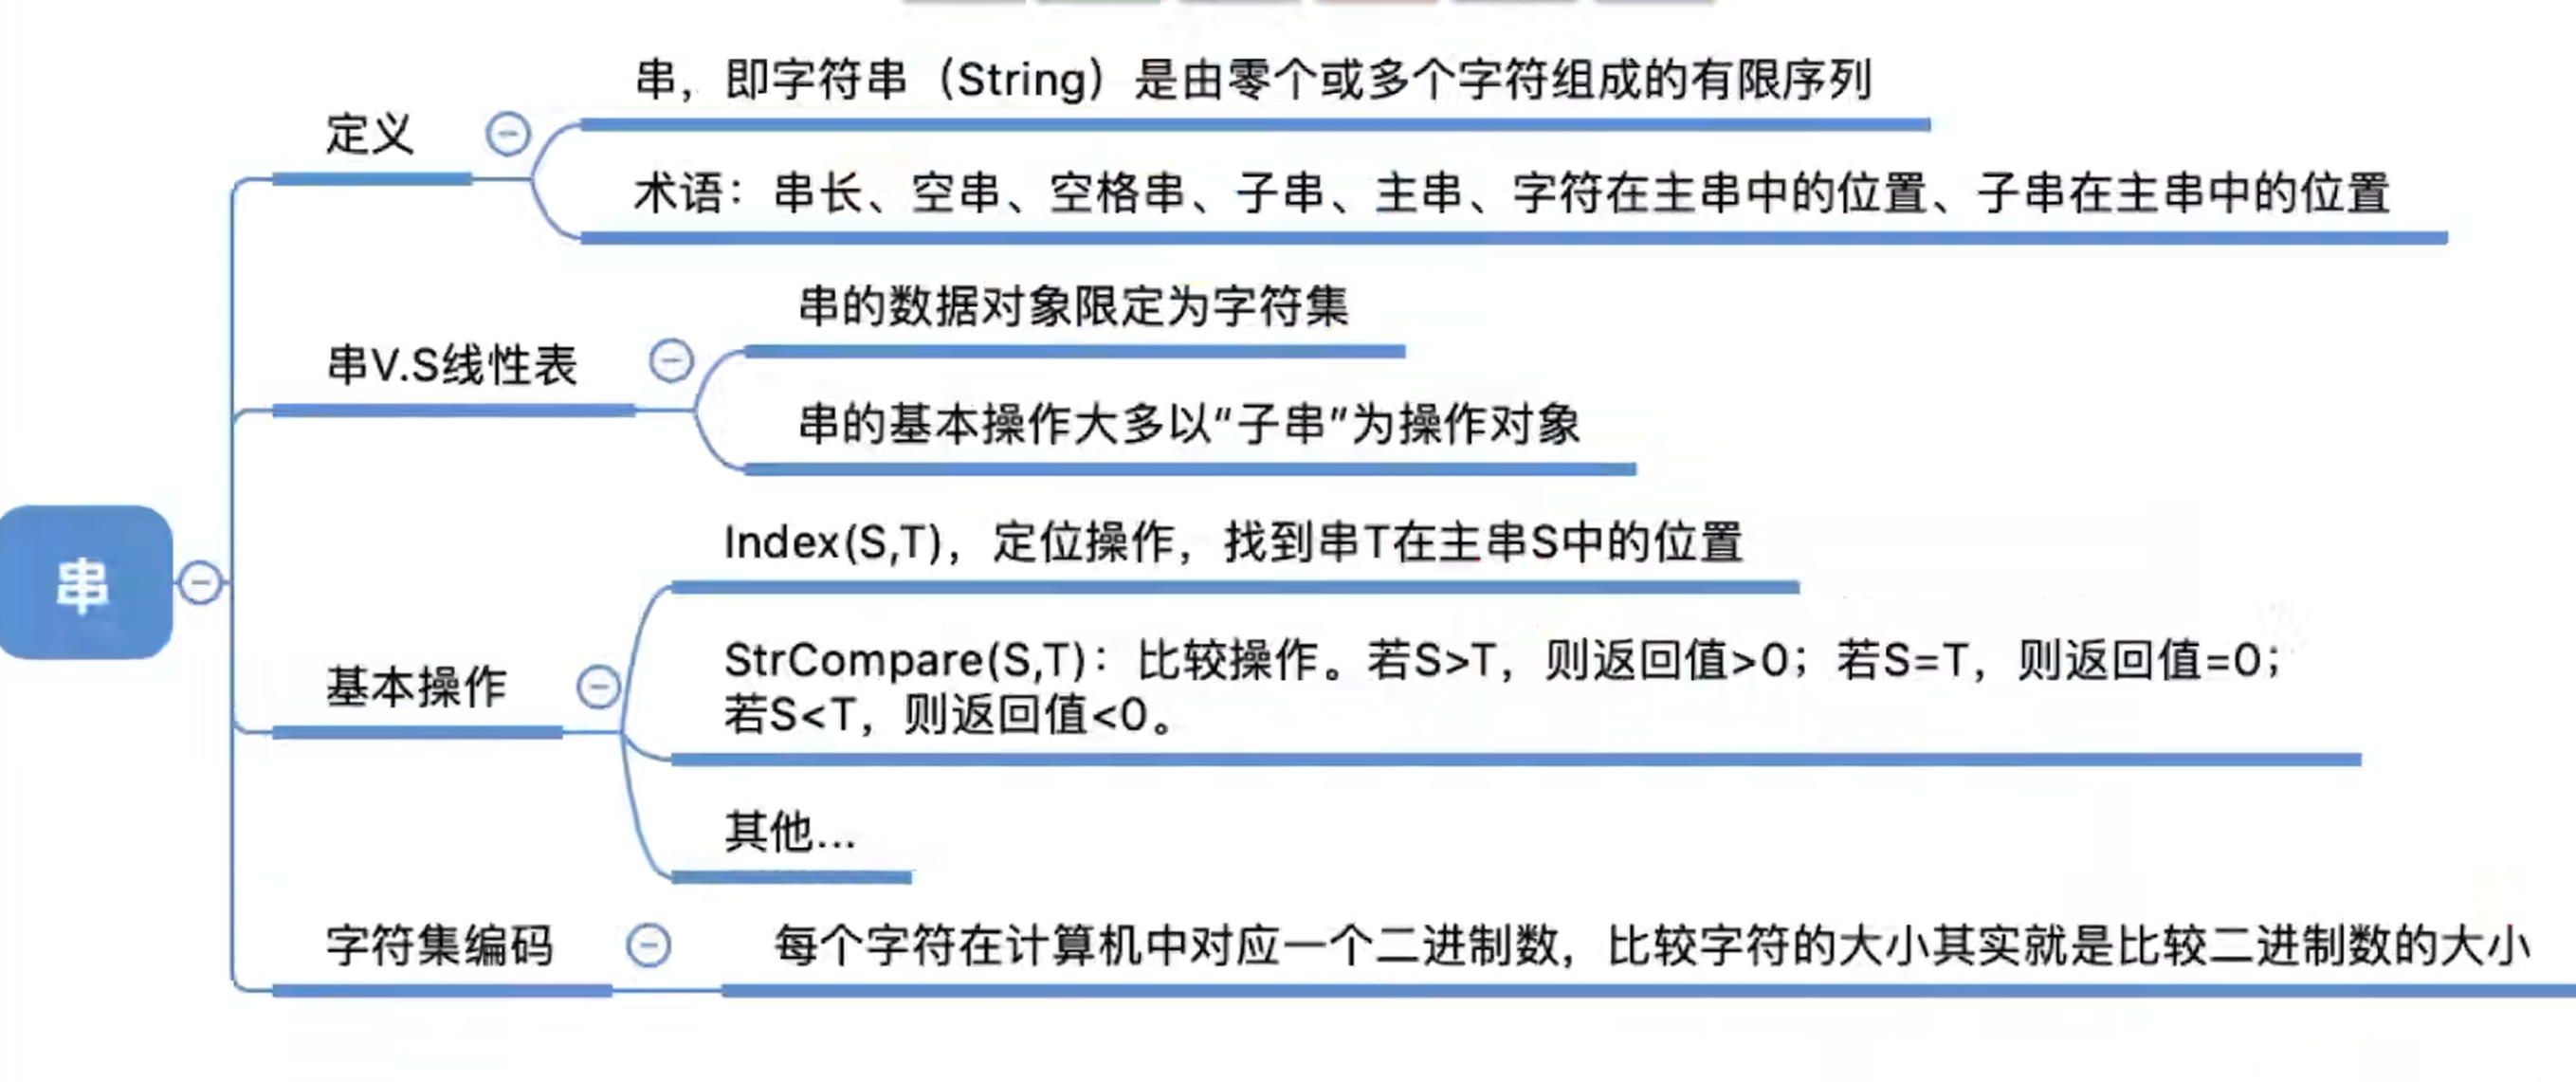
串的定义与基本操作
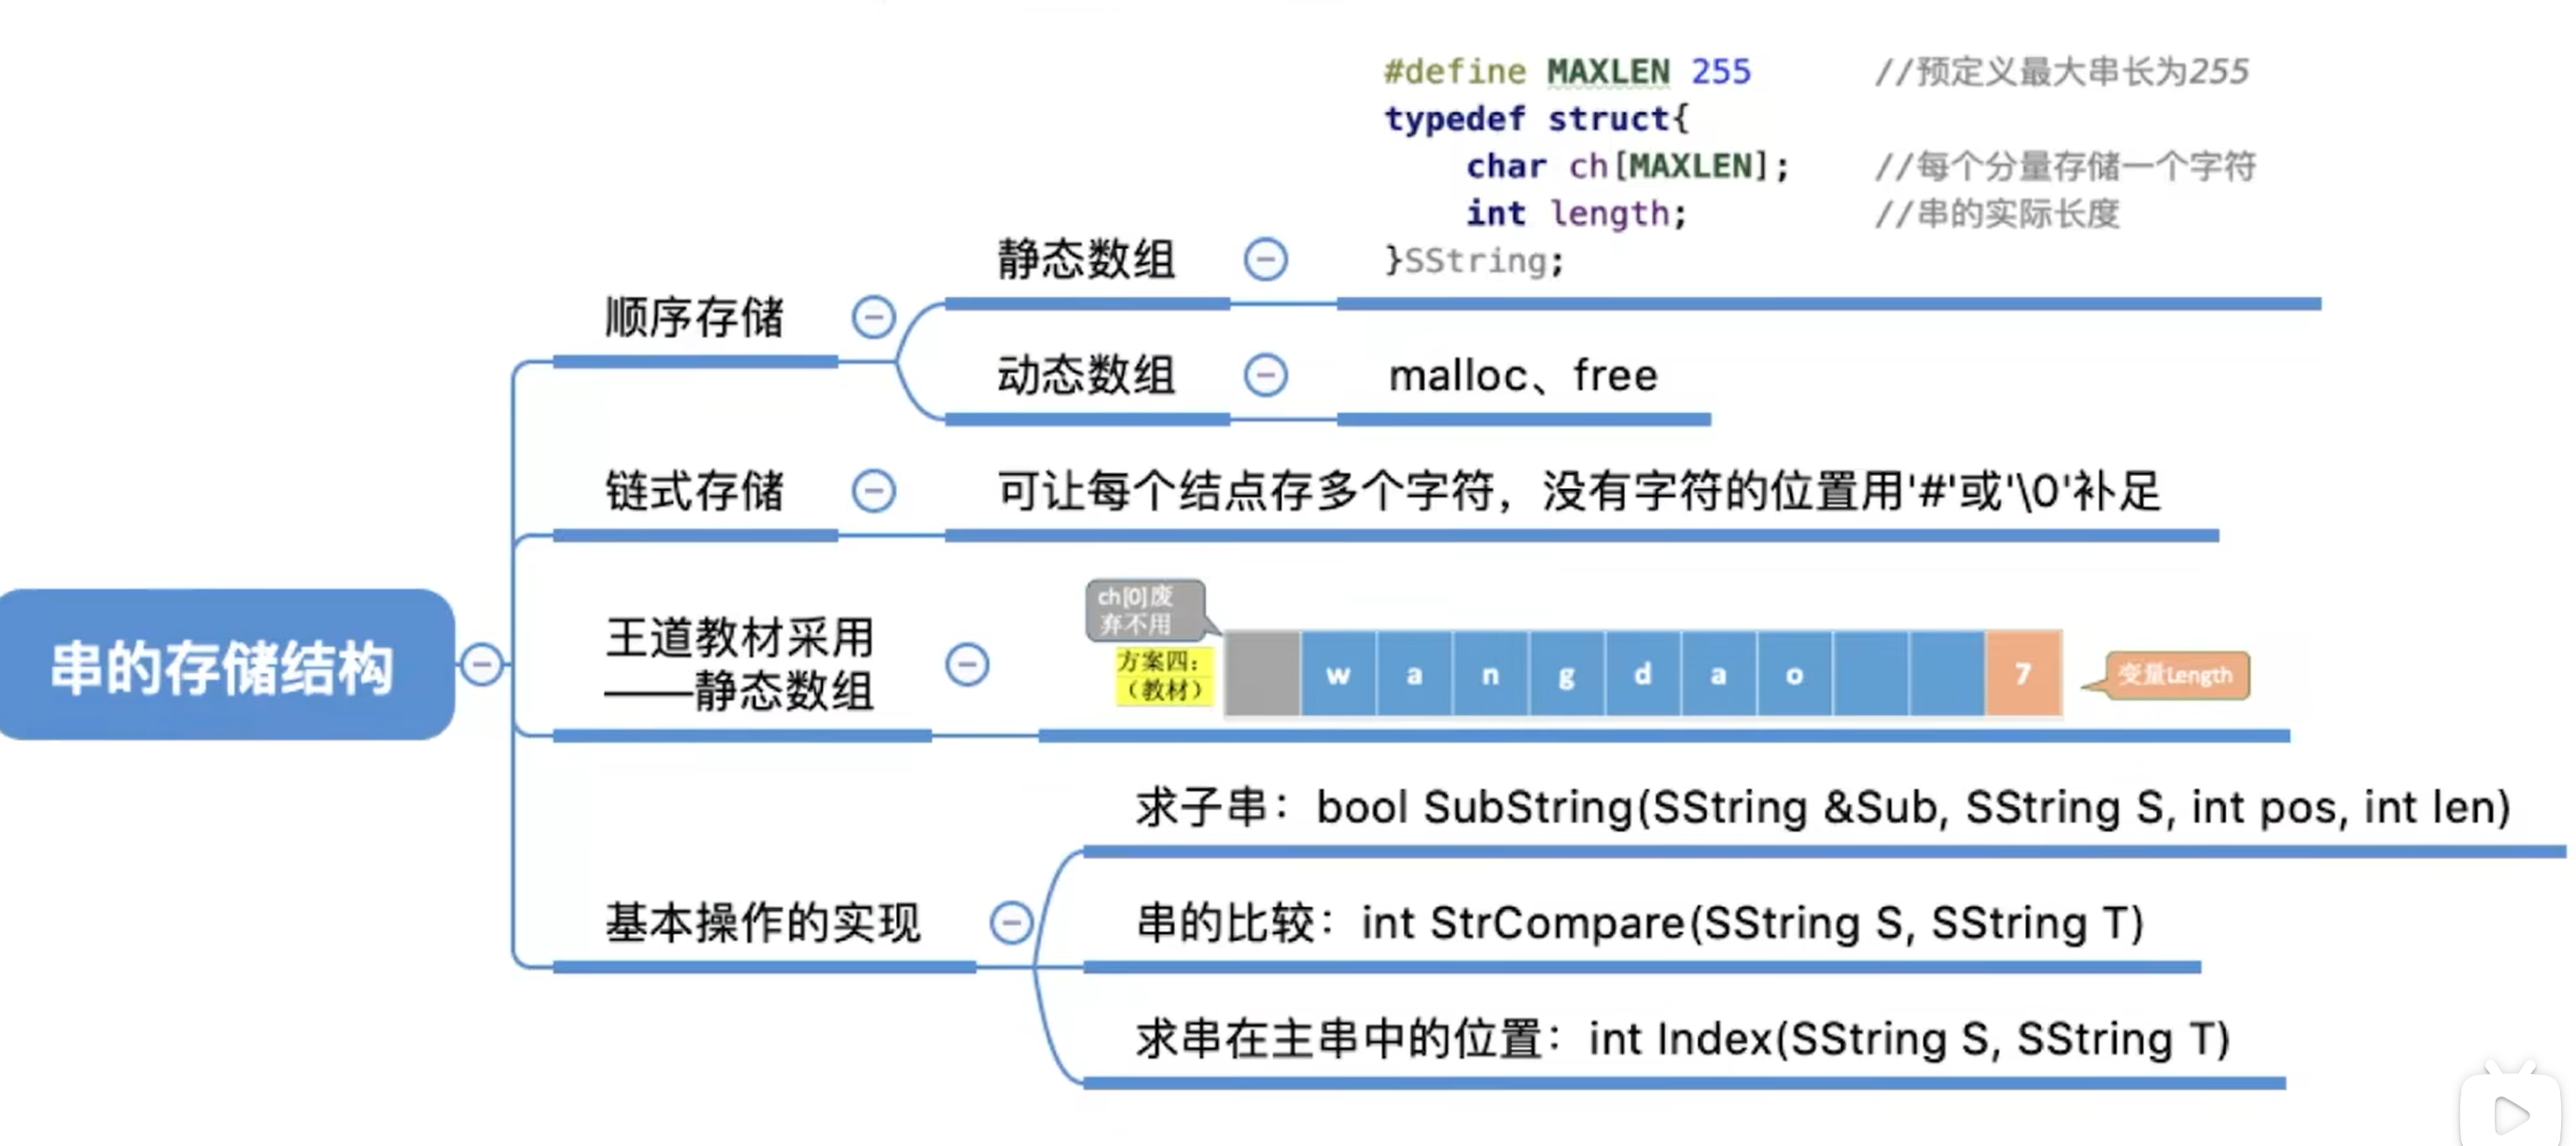
串的存储结构
串的模式匹配
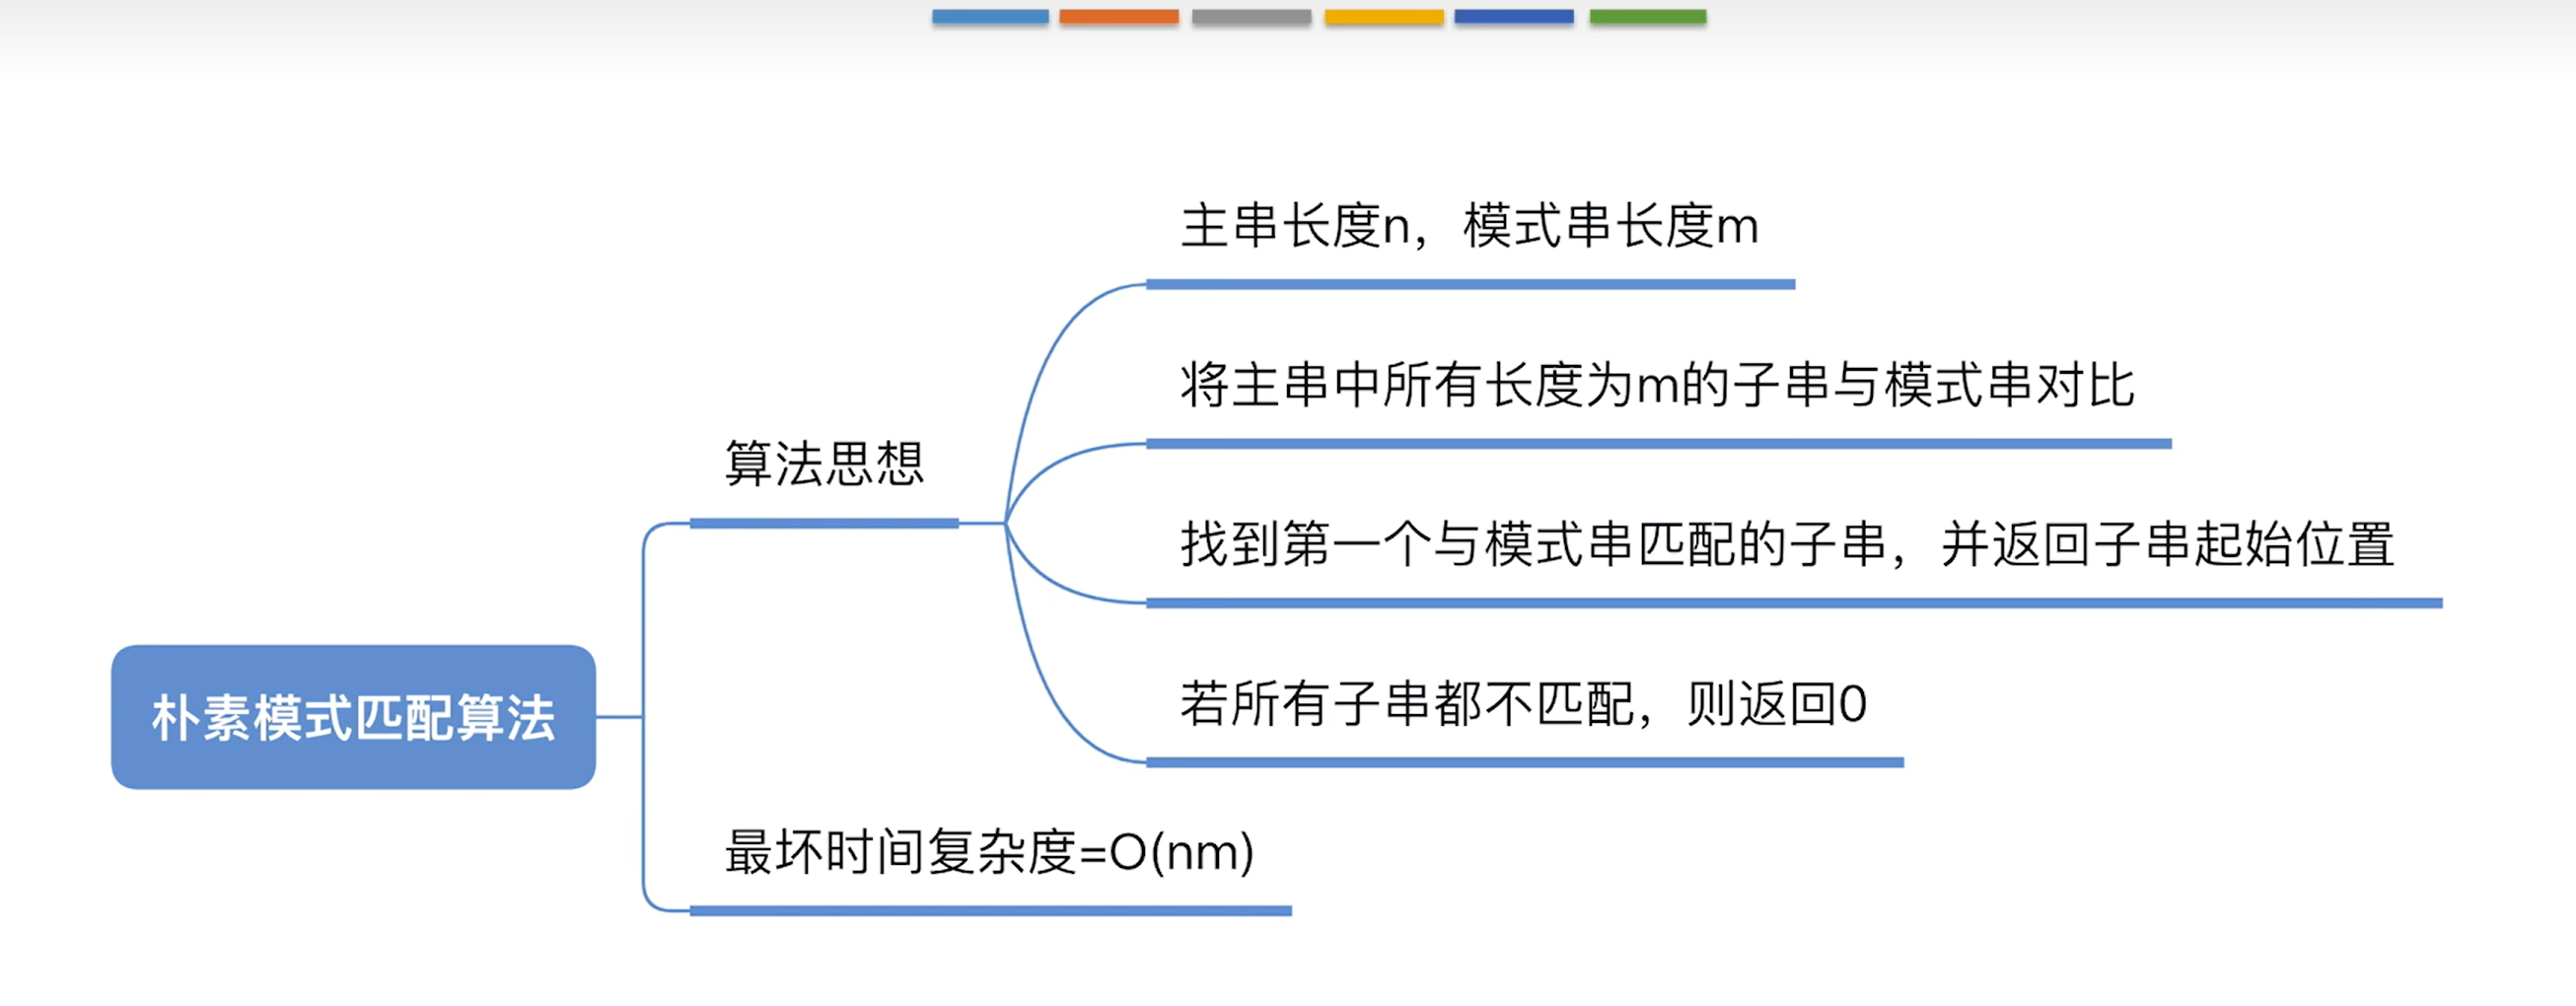
暴力
KMP
next数组
-
真前缀 (Proper Prefix)
-
定义: 包含字符串首字母,但不包含尾字母的所有子串。
- 通俗理解: 从头开始截取,但不能把整个字符串都截取完。
- 举例: 对于字符串
"aabaa" - 它的真前缀包括:
"a","aa","aab","aaba" -
(注意:
"aabaa"本身不算真前缀) -
真后缀 (Proper Suffix)
-
定义: 包含字符串尾字母,但不包含首字母的所有子串。
- 通俗理解: 从尾部倒着截取,但不能把整个字符串都截取完。
- 举例: 对于字符串
"aabaa" - 它的真后缀包括:
"a","aa","baa","abaa" -
(注意:
"aabaa"本身不算真后缀) -
next数组
-
含义一:ne[i]为在子串(模式串)中不含当前下标i对应的字母,前面字符串的最大前后缀区间匹配长度。
- 含义二:ne[i]为子串前缀S2[0 ~ ne[j]]的下个字符的索引,即ne[j] + 1,也就是我们接下来要和S1[匹配失败处]进行匹配的字符的索引。
next数组如何进行加速
假设此时next数组已经求出
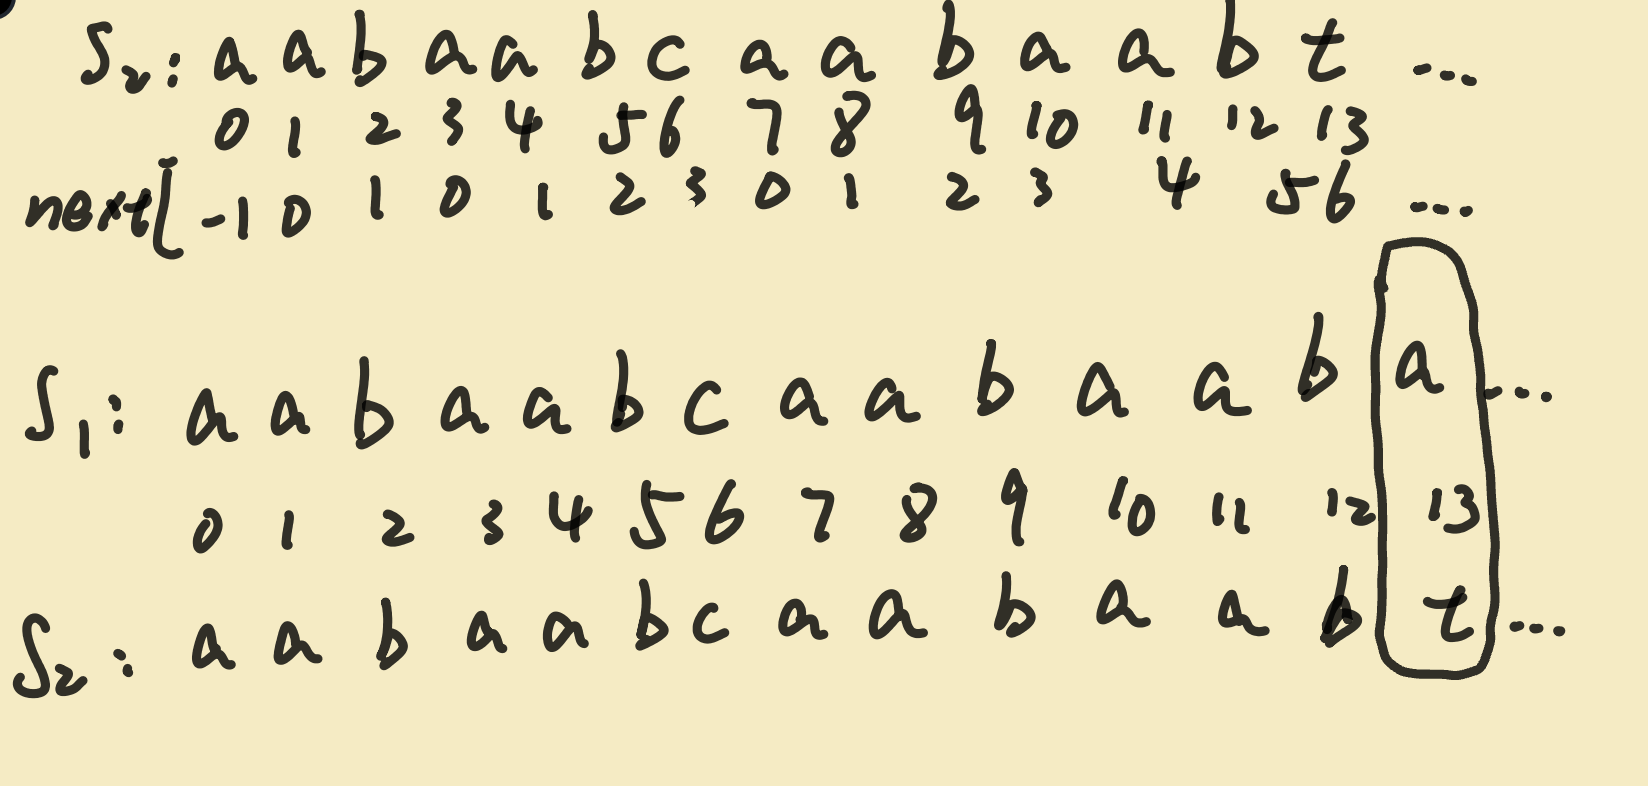
假设现在主串为S1,模式串为S2,并且next数组已经求出。
此时在下标为13时,S1与S2无法匹配,那么如果按照之前暴力写法的话,就需要让S1[1]与S2[0]进行比较,重新开始。
而next数组,就是可以直接放弃,跳过中间的部分比较,让S1[13]与S2[ne[13]]进行比较。
那为什么可以直接跳过呢?
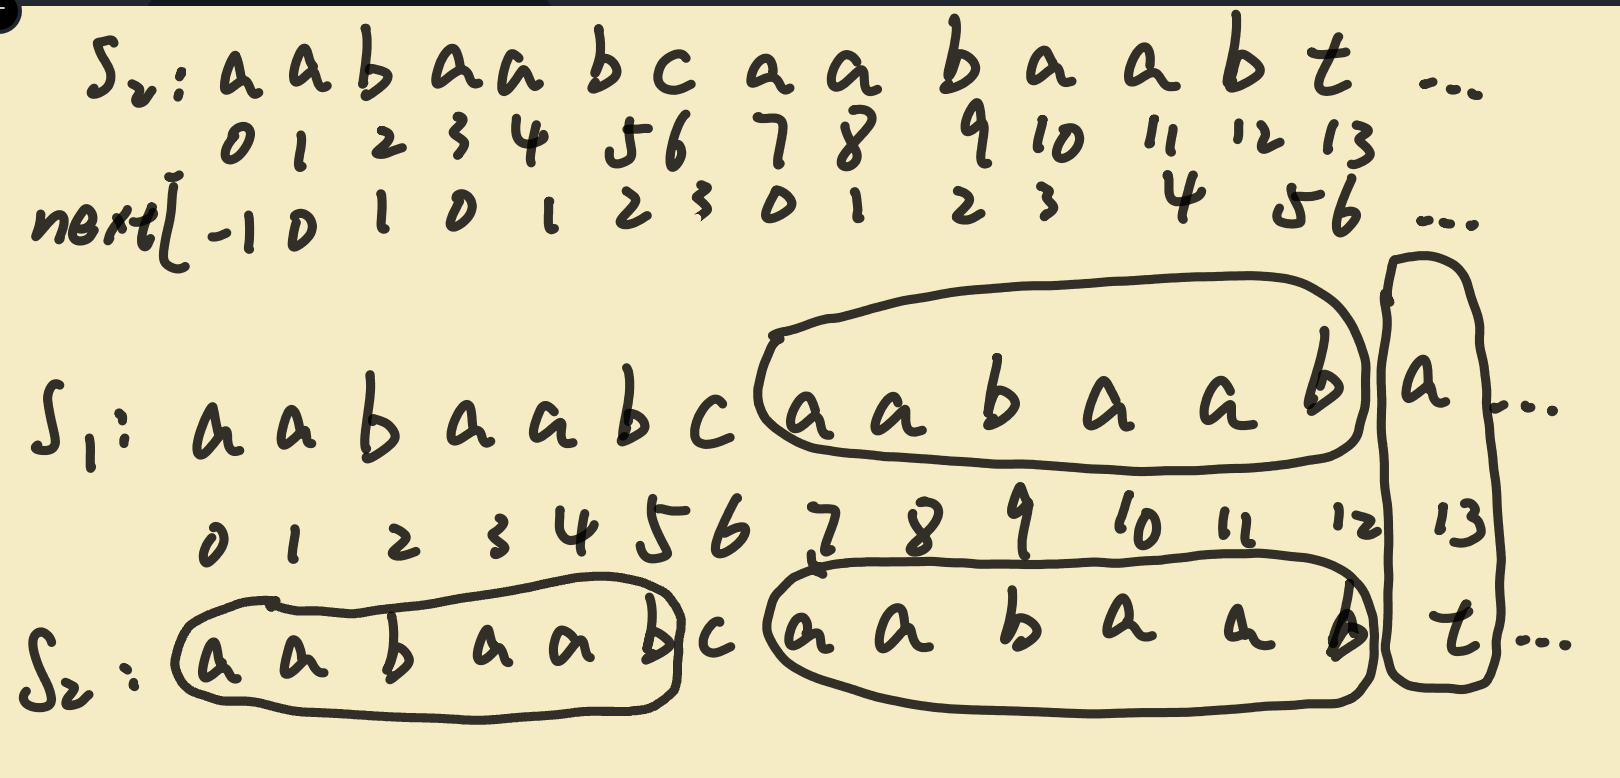
不难发现,S2中0 ~ 5对应的字符和S1中7 ~ 12是一模一样的,因为S2[7 ~ 12] == S1[7 ~ 12] (因为如果不相等怎么可能比到13...),而S2[7 ~ 12] == S2[0 ~ 5] (因为这正是next数组的含义),因此我们可以直接跳过中间没必要的比较,从而达到加速。
那么,一定会有疑惑,那中间省略的部分一定配不出来吗?
答案是肯定的,一定配不出来
为什么?
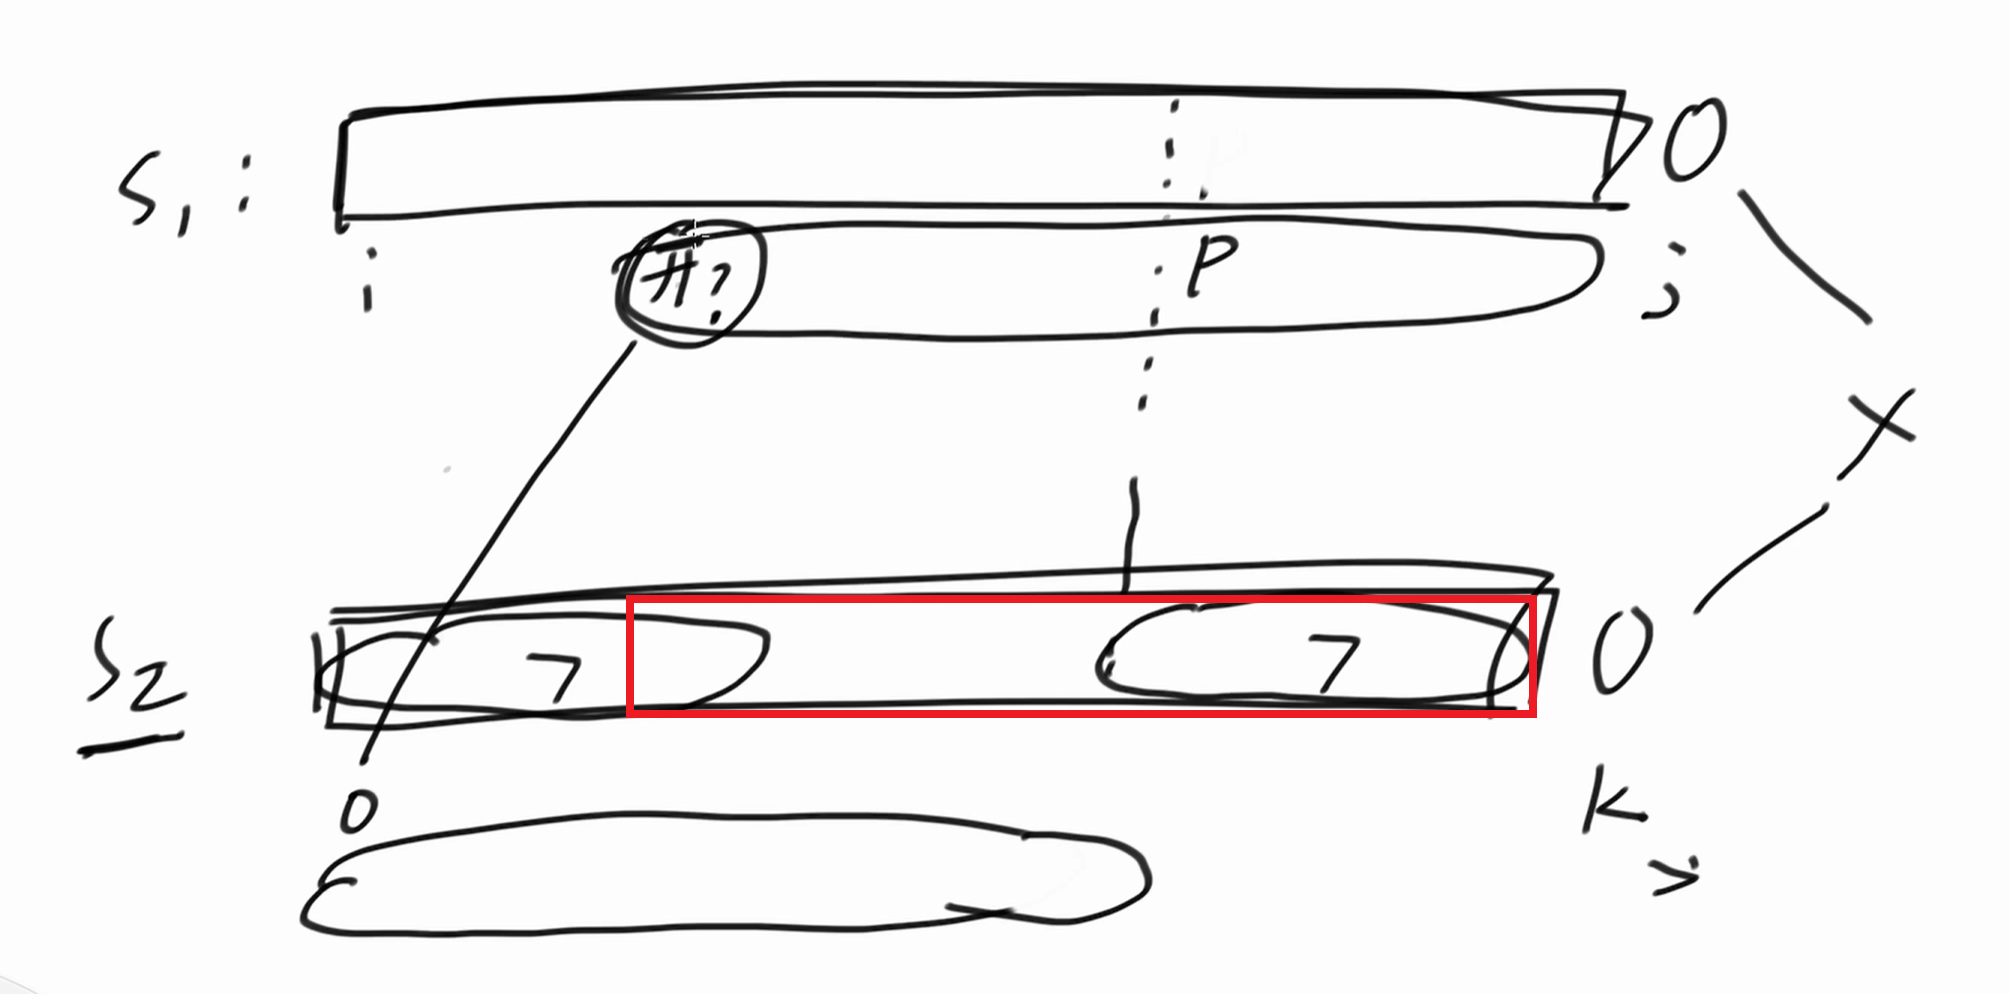
假设现在S1中存在一个开头,使得S1[开头 ~ j - 1] == S2[0 ~ 开头 - j + 2],同时也一定满足 S1[开头 ~ j - 1] == S2红框(因为比到 j 和 k 时不相等,前面一定都相等),那么此时S2[0 ~ 开头 - j + 2] == S2红框,这不就是ne[k]吗?但是ne[k]不是7吗(此时假设),这就产生了矛盾,因此绝对这个开头绝对不存在!!!
那么此时就有了新问题,接下来呢?
- 如果S1[13] == S2[ne[13]]
-
S1 S2指针各往后移一位
-
如果S1[13] != S2[ne[13]]
-
接着ne,比较S1[13] 和 S2[ne[ne[13]]]...
-
最后找到了,那就指针后移
- 最后没找到,S2的指针跳到了 -1 也就意味着S2前面所有的字符全都被放弃了,S1指针后移一位,重新开始匹配S2
next数组如何快速算出
next[0] = -1, next[1] = 0是一定的
假设此时情况为
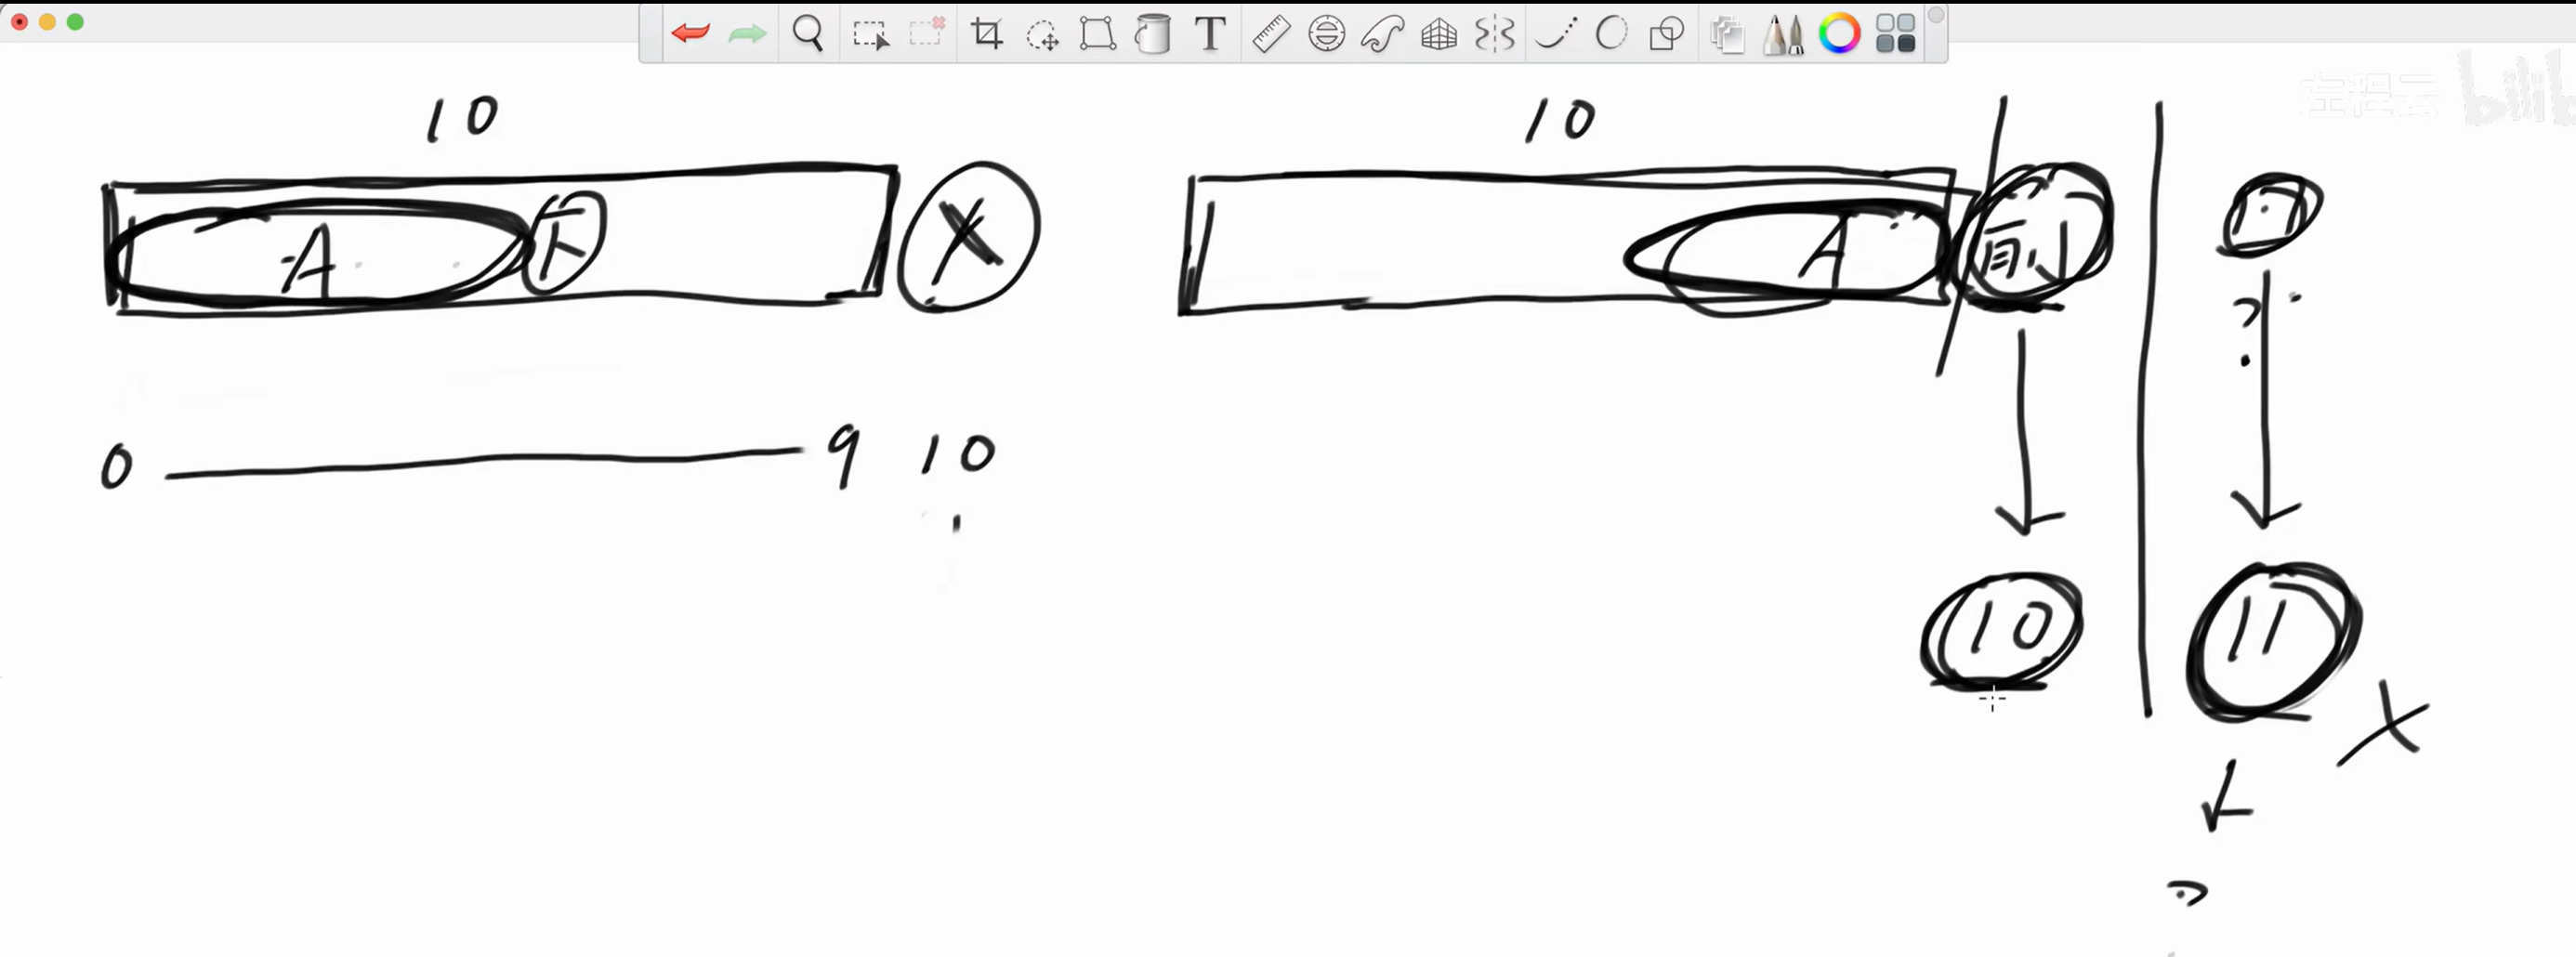
我们要求竖线右边的字符的ne值,这里设其下标为x,此时,我们比对S2[x - 1]和S2[ne[x - 1]],如果一样,就另ne[x] = ne[x - 1] + 1
如果不相等,就试图保留最长的前后缀(贪心思想,尽量少比),那么就继续找ne[ne[x - 1]]... 直到找不到,令ne[x] = 0。
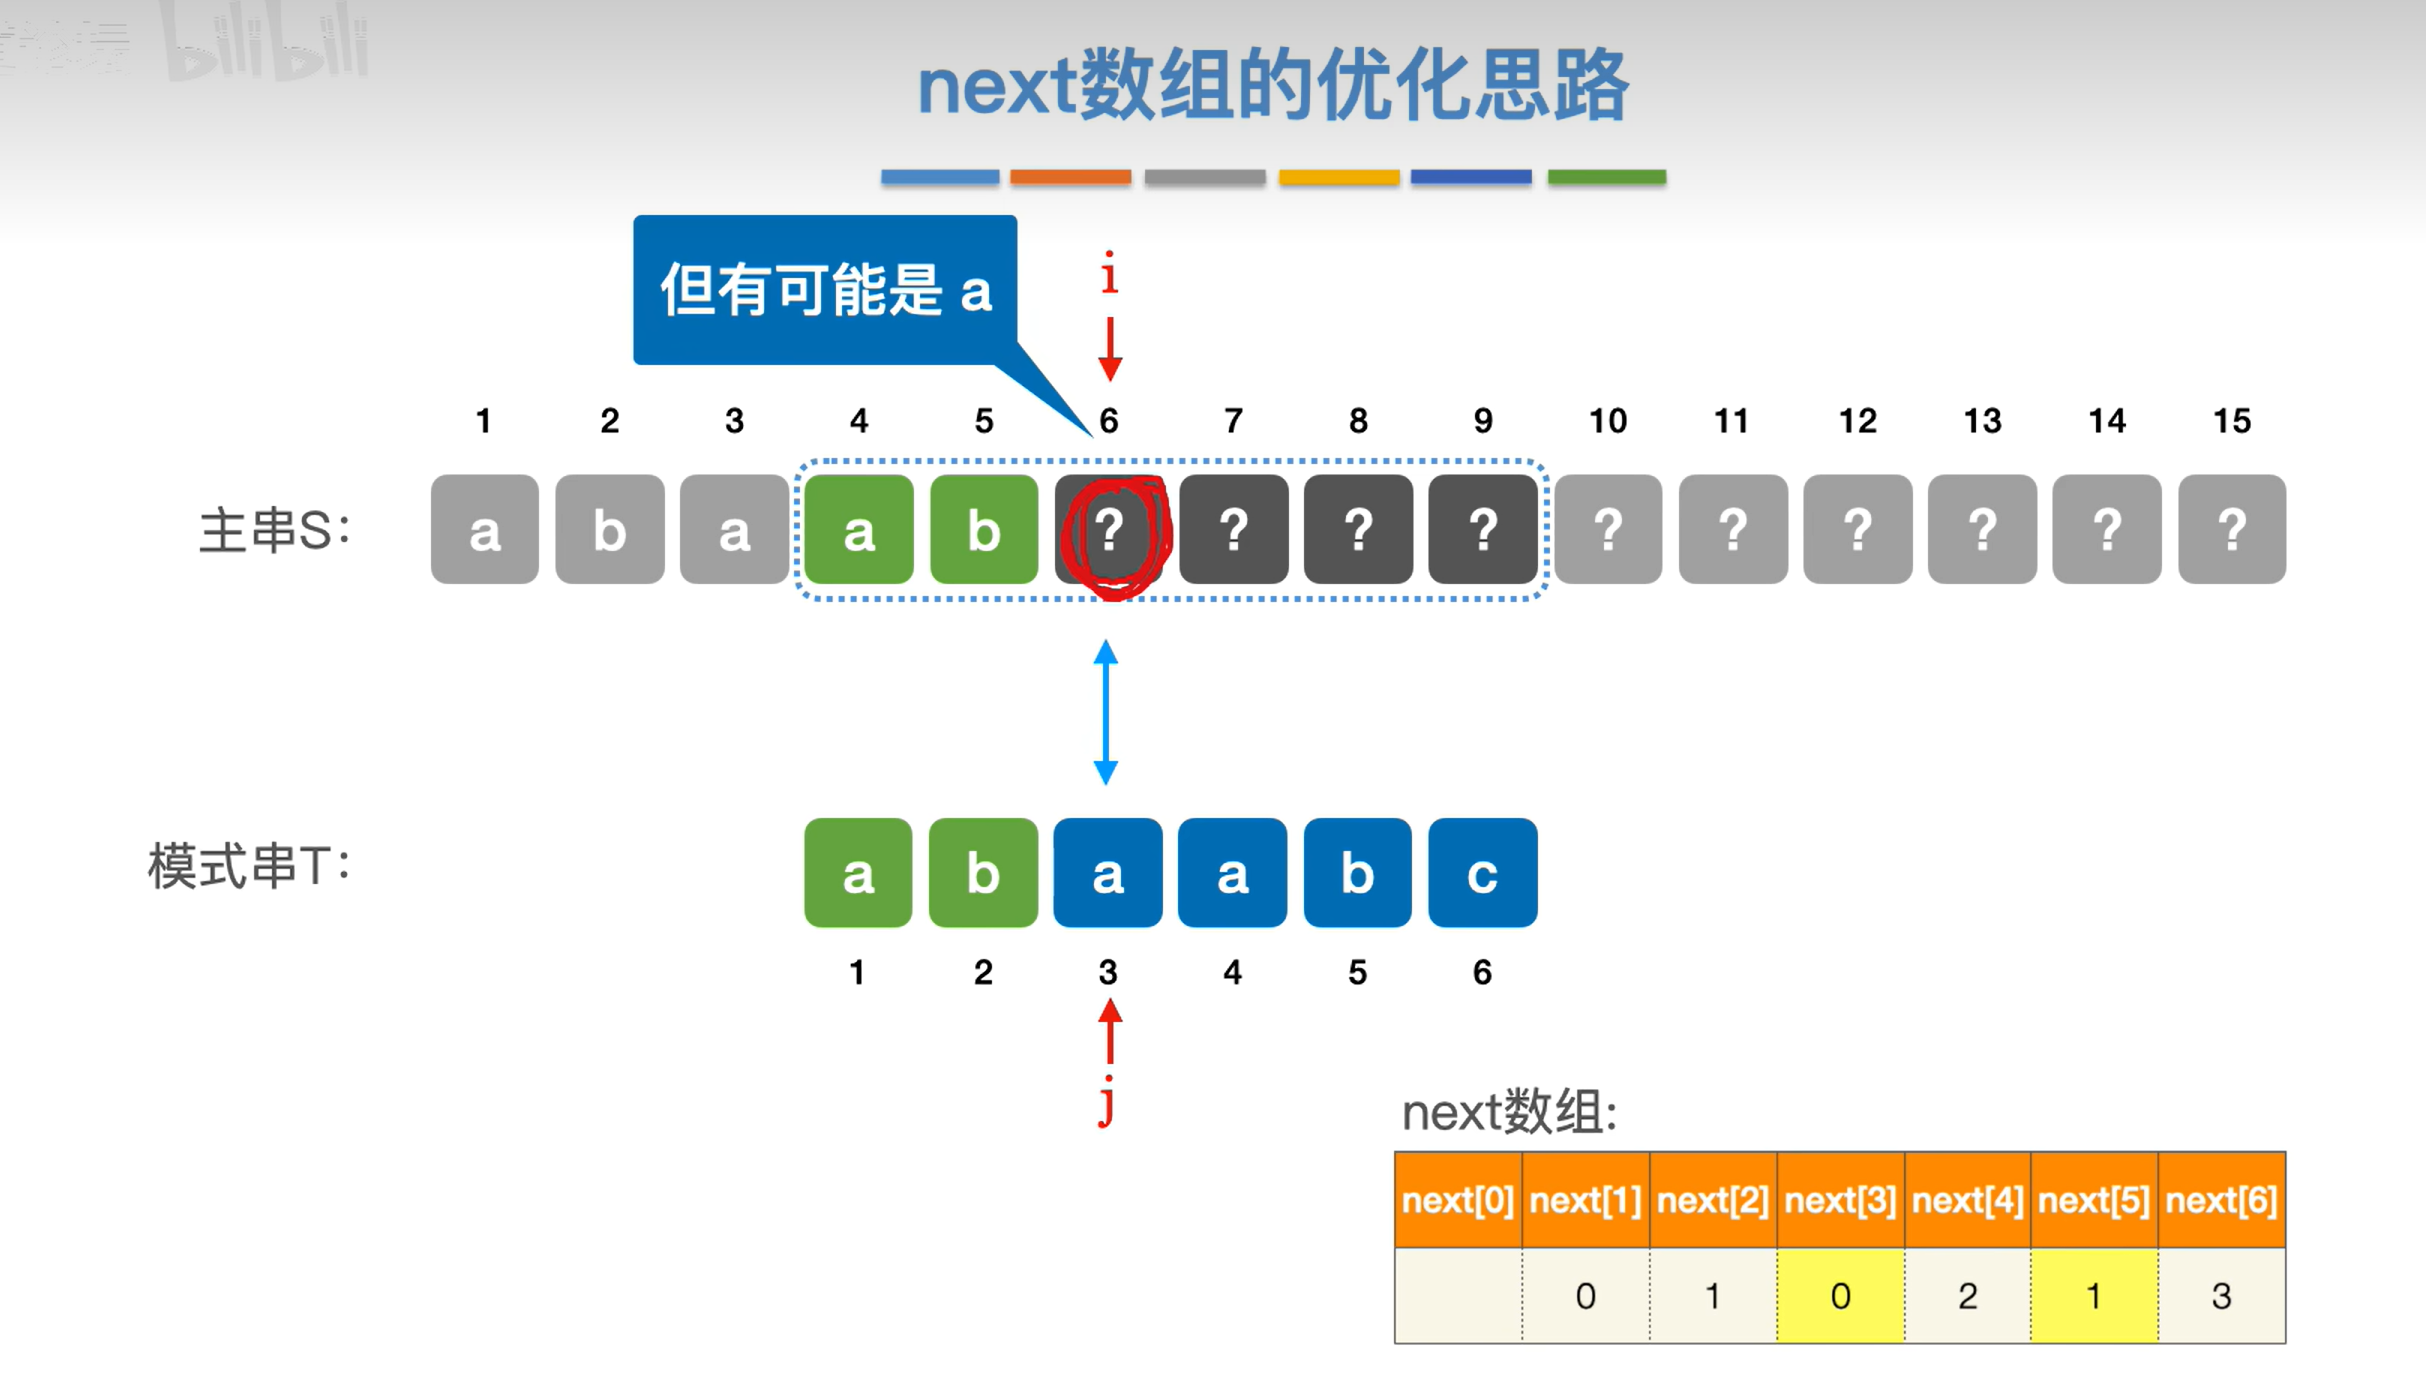
KMP的优化
所谓的KMP优化其实算法核心并没有变,只是对ne数组进行了优化
注意,此处ne数组的前后缀并不是真前后缀,是包含自身的,所以从0开始,而不是-1,考试中也是如此
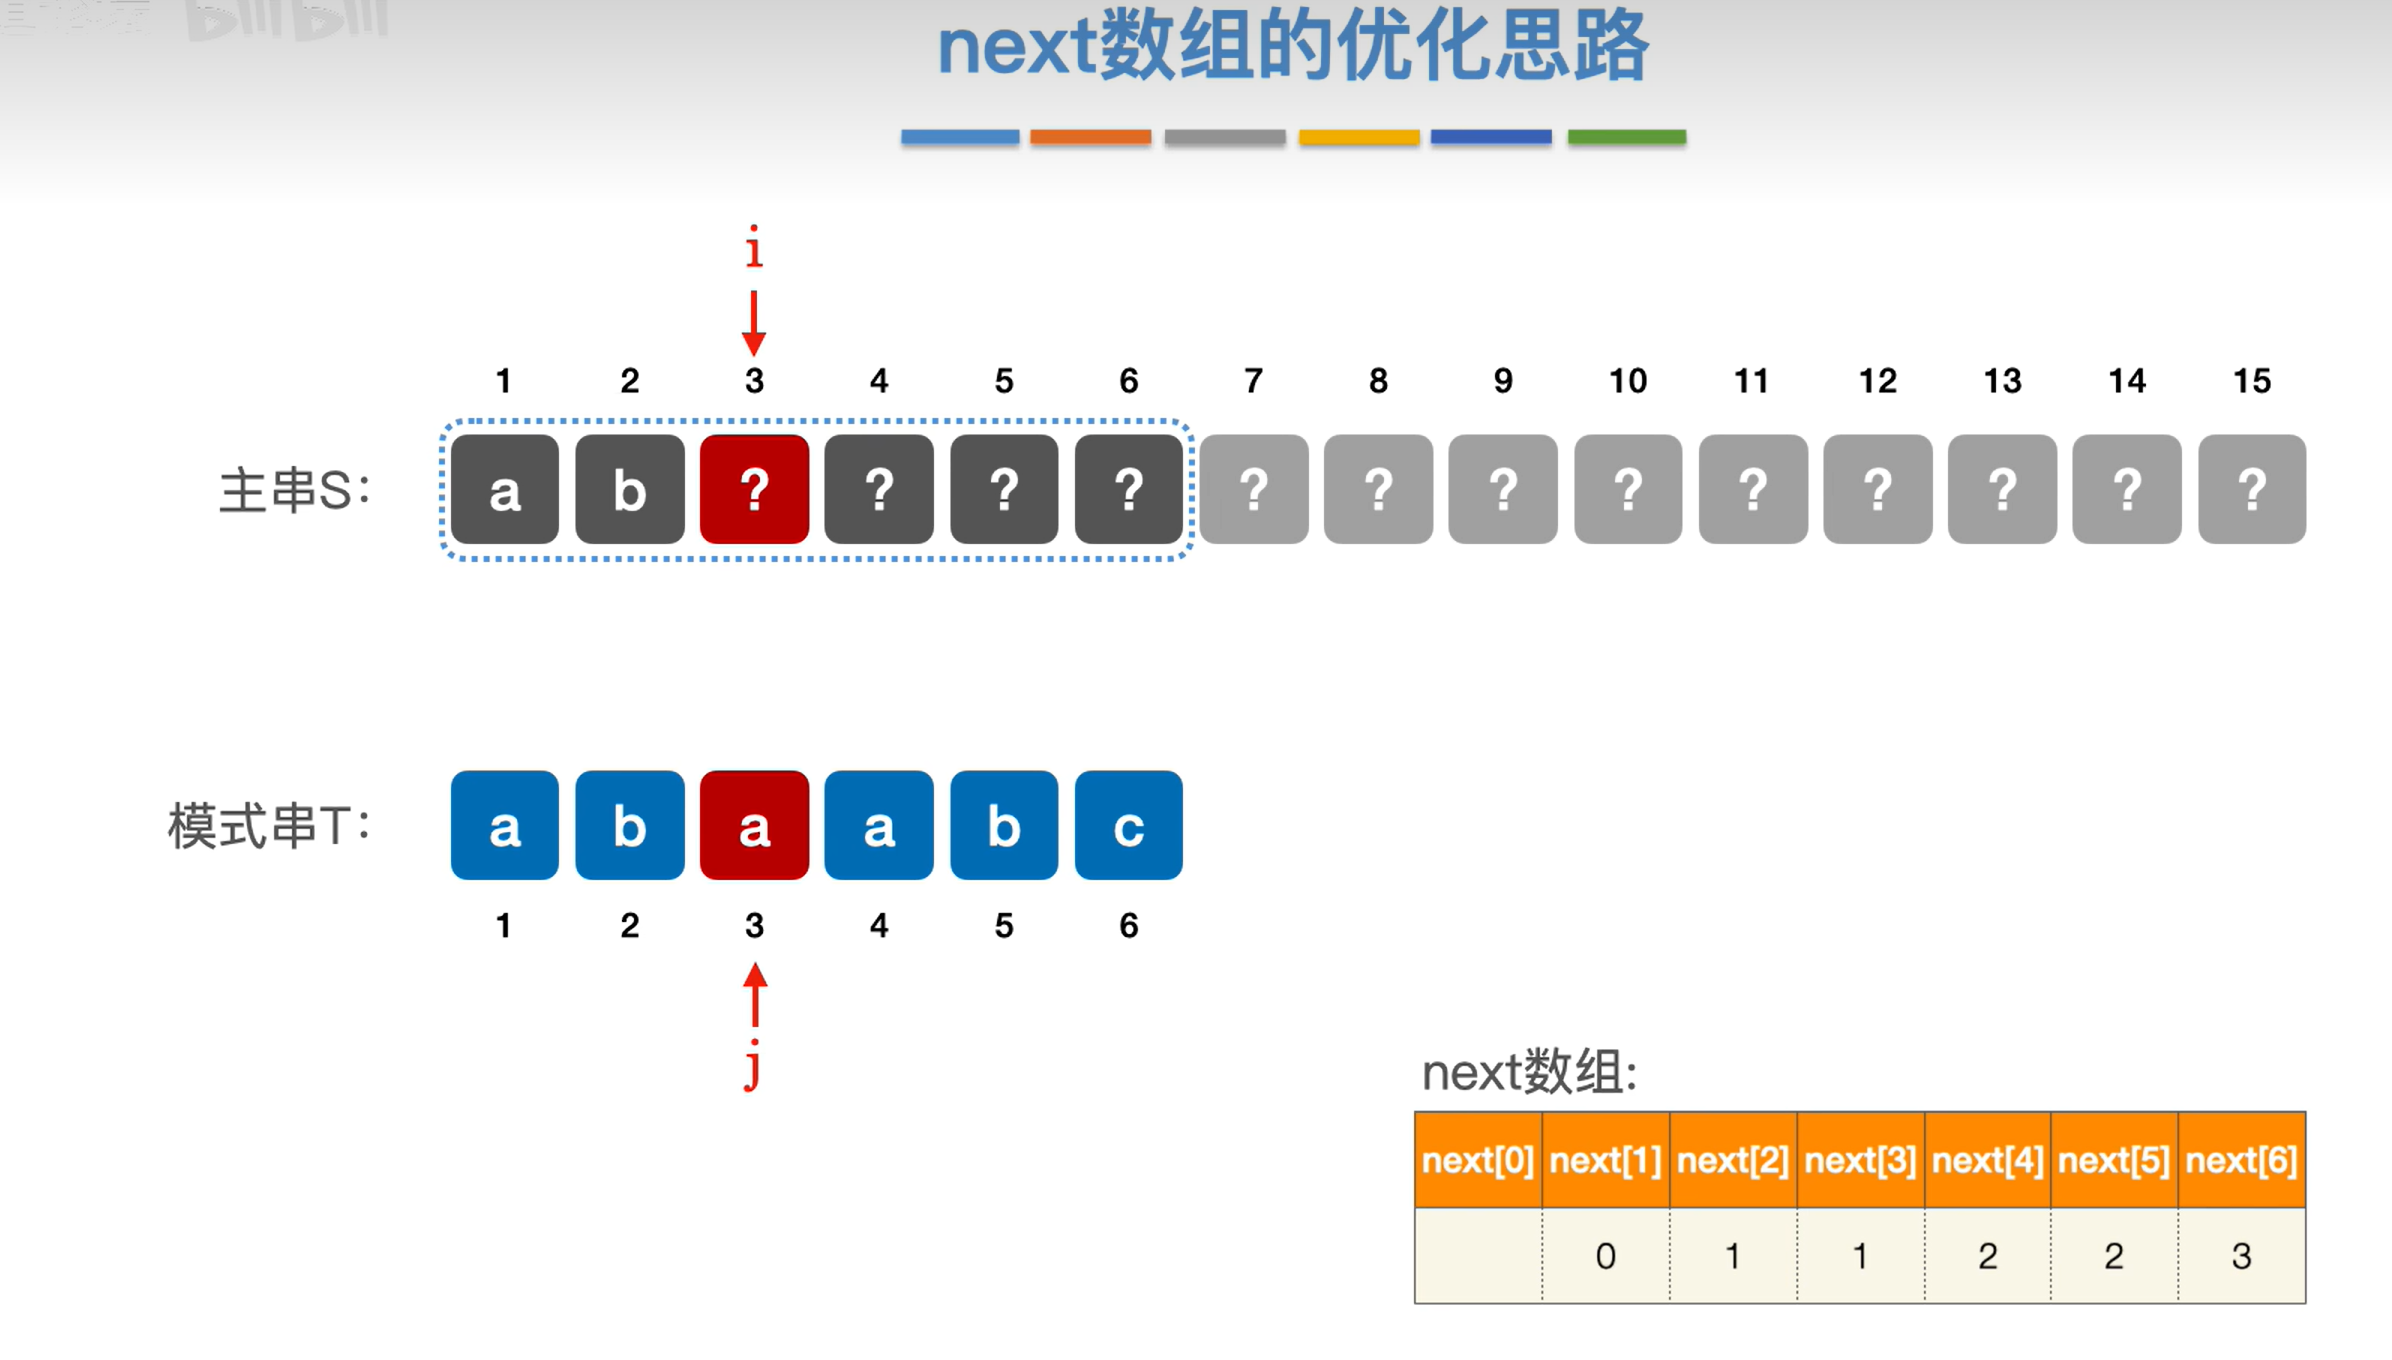
如图,当S[i] != T[j]时,再去比对S[i]和T[ne[j]],但是T[ne[j]] == T[j],这就意味这我们没必要比这一次,可以把这一次优化掉,也就是令ne[j] = ne[ne[j]],从而减少对比次数,提升效率,对应的王道书中求nextval数组