计算机组成原理
主存地址空间与MAR(存储器地址寄存器)位数的关系
MAR的位数是由系统的主存地址空间大小决定的,代表了CPU最大能寻址的范围,与当前实际安装了多少容量的内存无关。
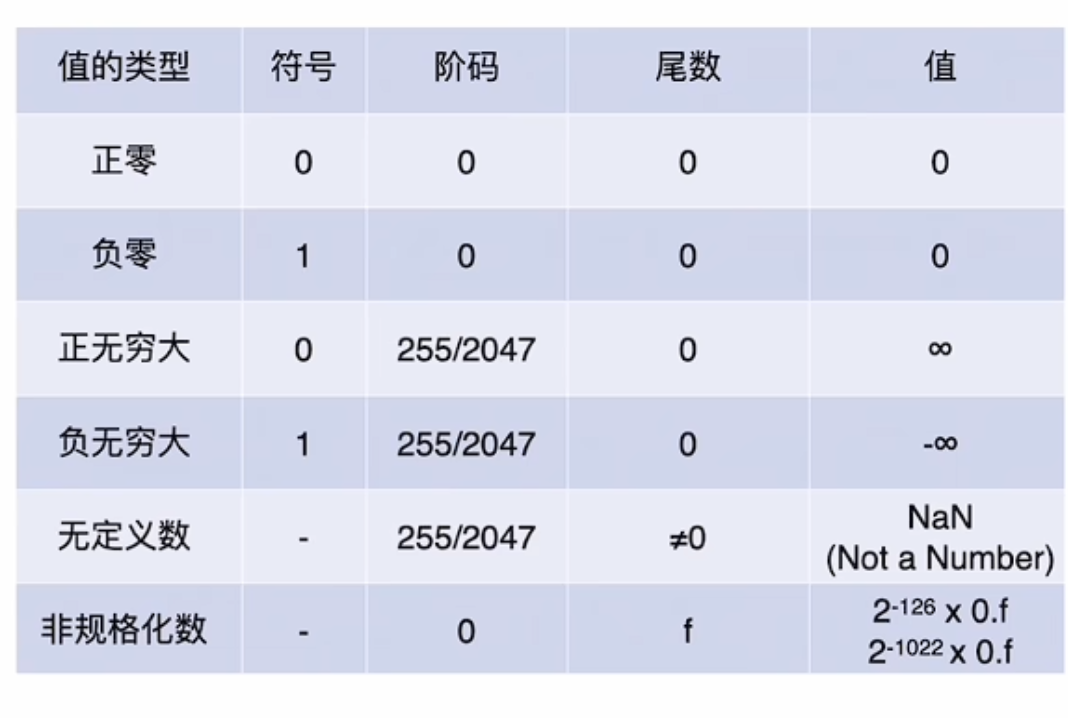
IEEE 754
- float (32位单精度浮点数)
总共占用 32 bits(4字节)。
| 结构划分 | 符号位 (S) | 阶码/指数 (E) | 尾数 (M) |
|---|---|---|---|
| 位数 | 1 位 | 8 位 | 23 位 |
| 含义 | 0 为正,1 为负 |
采用移码表示(偏移量为 127) | 隐藏最高位的 1,只存小数部分 |
- double (64位双精度浮点数)
总共占用 64 bits(8字节)。
| 结构划分 | 符号位 (S) | 阶码/指数 (E) | 尾数 (M) |
|---|---|---|---|
| 位数 | 1 位 | 11 位 | 52 位 |
| 含义 | 0 为正,1 为负 |
采用移码表示(偏移量为 1023) | 隐藏最高位的 1,只存小数部分 |
- 牢记,牢记。若问及最大非规格化正数应当是最小规格化正数 - 最小非规格化正数。也即是2^-126^ - 2^-126^ * 2^-23^即\[(1 - 2^{-23}) \times 2^{-126}\]
栈空间的访问
栈本质上就是主存(RAM)中划出来的一片普通存储区域而已,因此可以使用普通的访存指令实现对栈空间的读写。
计算操作控制字段的尾数
“字段直接编码法”必须在每个字段中留出一个状态来表示“不操作”。
中断
-
INTR(可屏蔽)和NMI(不可屏蔽)都是外中断,都需要在一条指令结束后进行响应。只有内中断可以在一条指令执行中进行响应。
-
优先级排名:DMA请求 > 硬件故障 (NMI) > 内中断 (异常) > DMA结束中断 (高速 INTR) > 普通 I/O 中断 (低速 INTR)
-
外部设备通过中断控制器向CPU发中断请求信号。当中断处理完成后,通常是由CPU向中断控制器发送中断结束信号,告知中断控制器该中断已处理完毕。
逻辑移位和算数移位
算数移位才需要符号扩充。
CF与OF
1. 关于 CF(无符号数进位/借位标志)
- 减法(瞪眼法): 直接看作无符号数,
A < B时一定产生借位,CF = 1。 - 加法(瞪眼法): 如果算出来的结果反而比其中任何一个加数还要小,就说明发生了进位溢出,此时
CF = 1(例如 8 位下 \(250 + 10 = 4\),\(4 < 250\),一眼就能看出CF = 1)。 - 公式推导: CF = Cout ^ Cin(Sub)
2. 关于 OF(有符号数溢出标志)
- 排除法(瞪眼法): 只有同号相加、异号相减才会溢出
- 公式推导: OF = Cn ^ Cn - 1(最高位产生的进位异或此高位产生的进位)。
- 一般方法: 老老实实算出来看符号位。
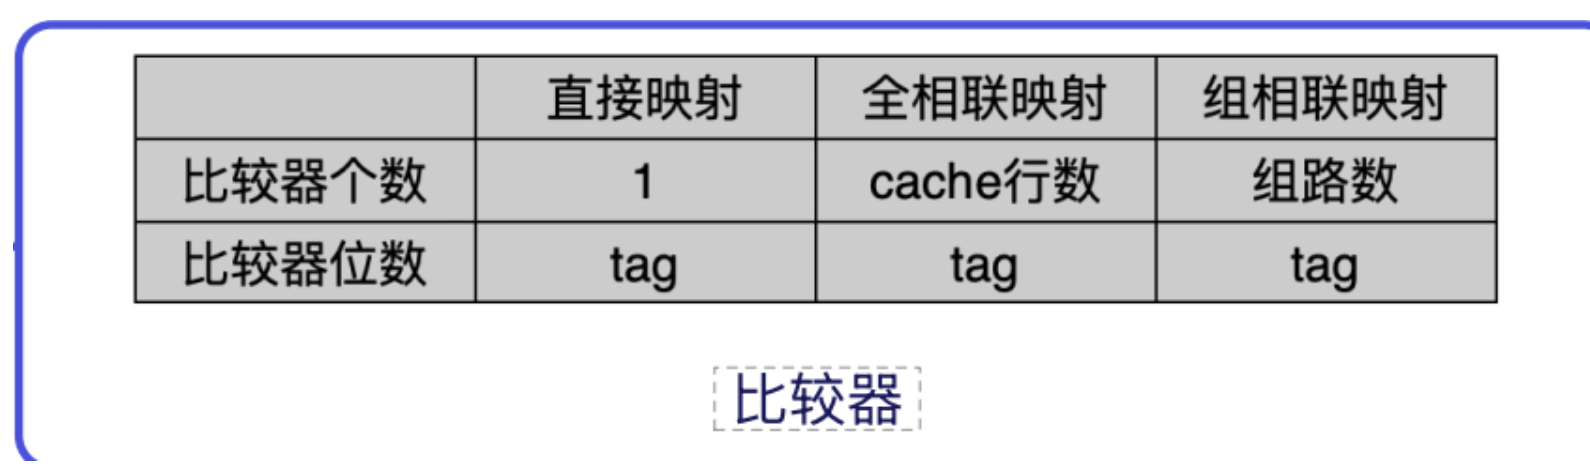
全相联、组相联、直接映射
全相联(所有块一个组)
组相联
直接映射(一个块一个组)
写策略
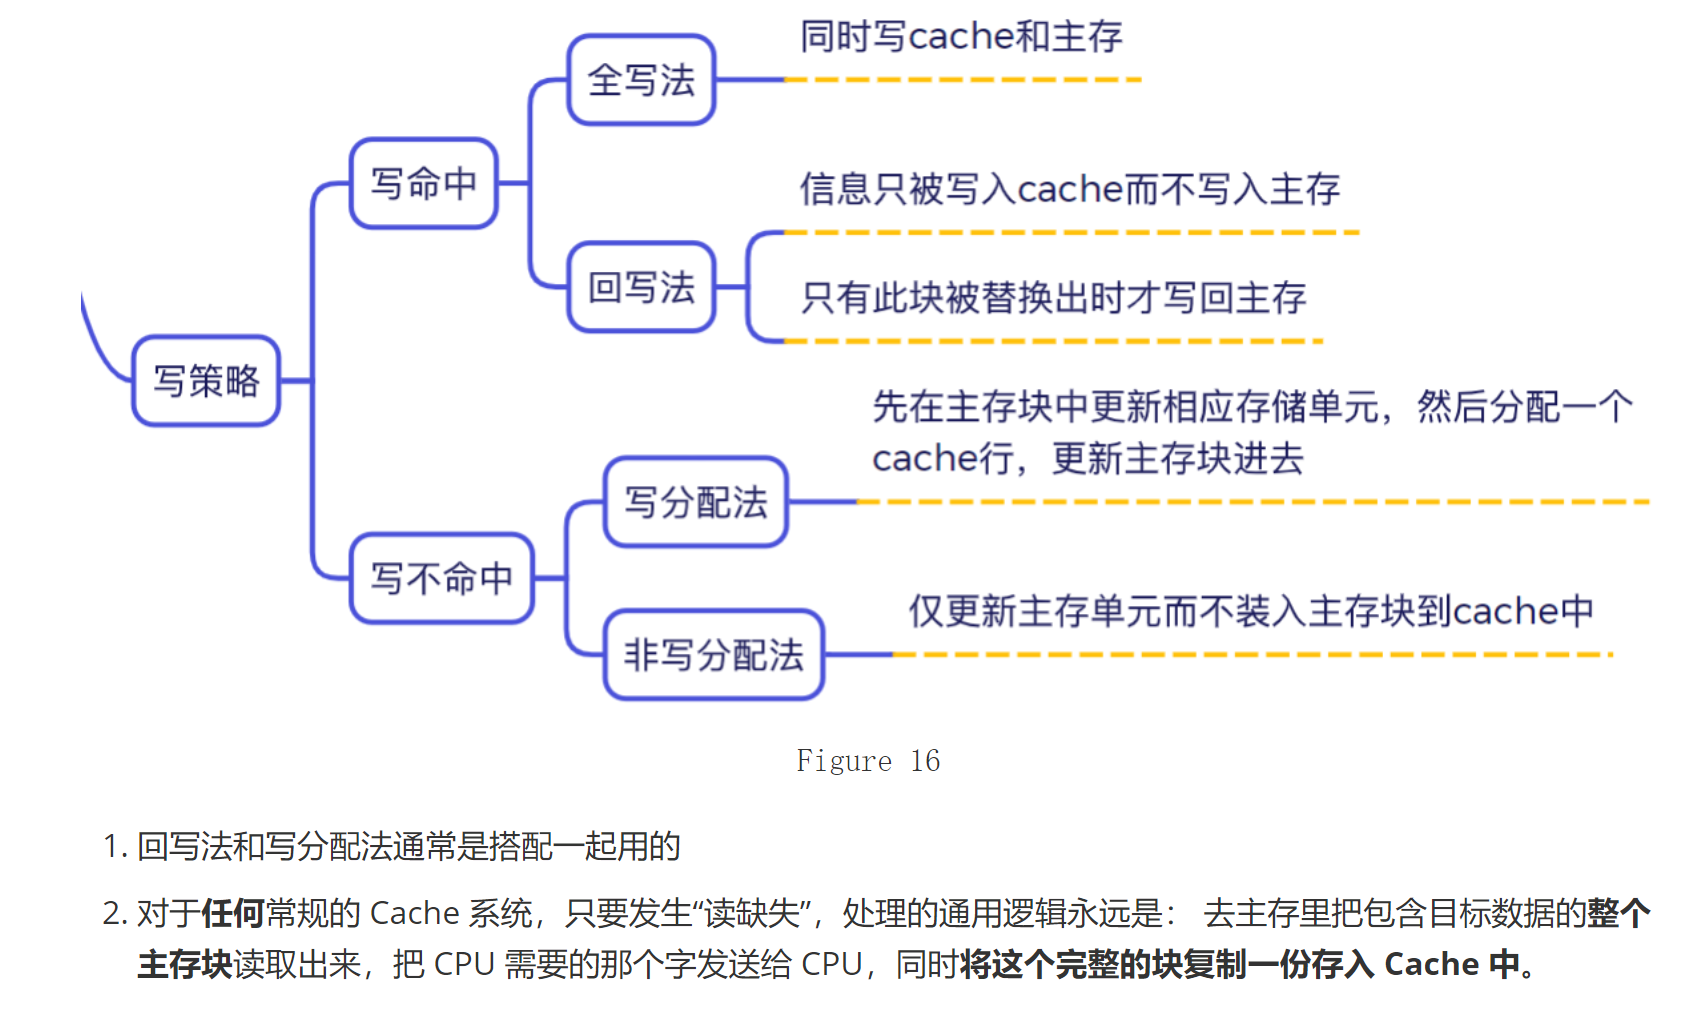
犬吠(全写法与非写分配法),回血(回写法与写分配法)
常见指令
lw(Load Word)sw(Store Word)beq(Branch if Equal)bne(Branch if Not Equal)
数据相关
当一条指令读取某个寄存器时,只需要向前找“最近一次写这个寄存器”的指令建立 RAW 数据相关;更早对这个寄存器的写入已经被后面的写入覆盖,因此不再是这次读取所依赖的数据来源。
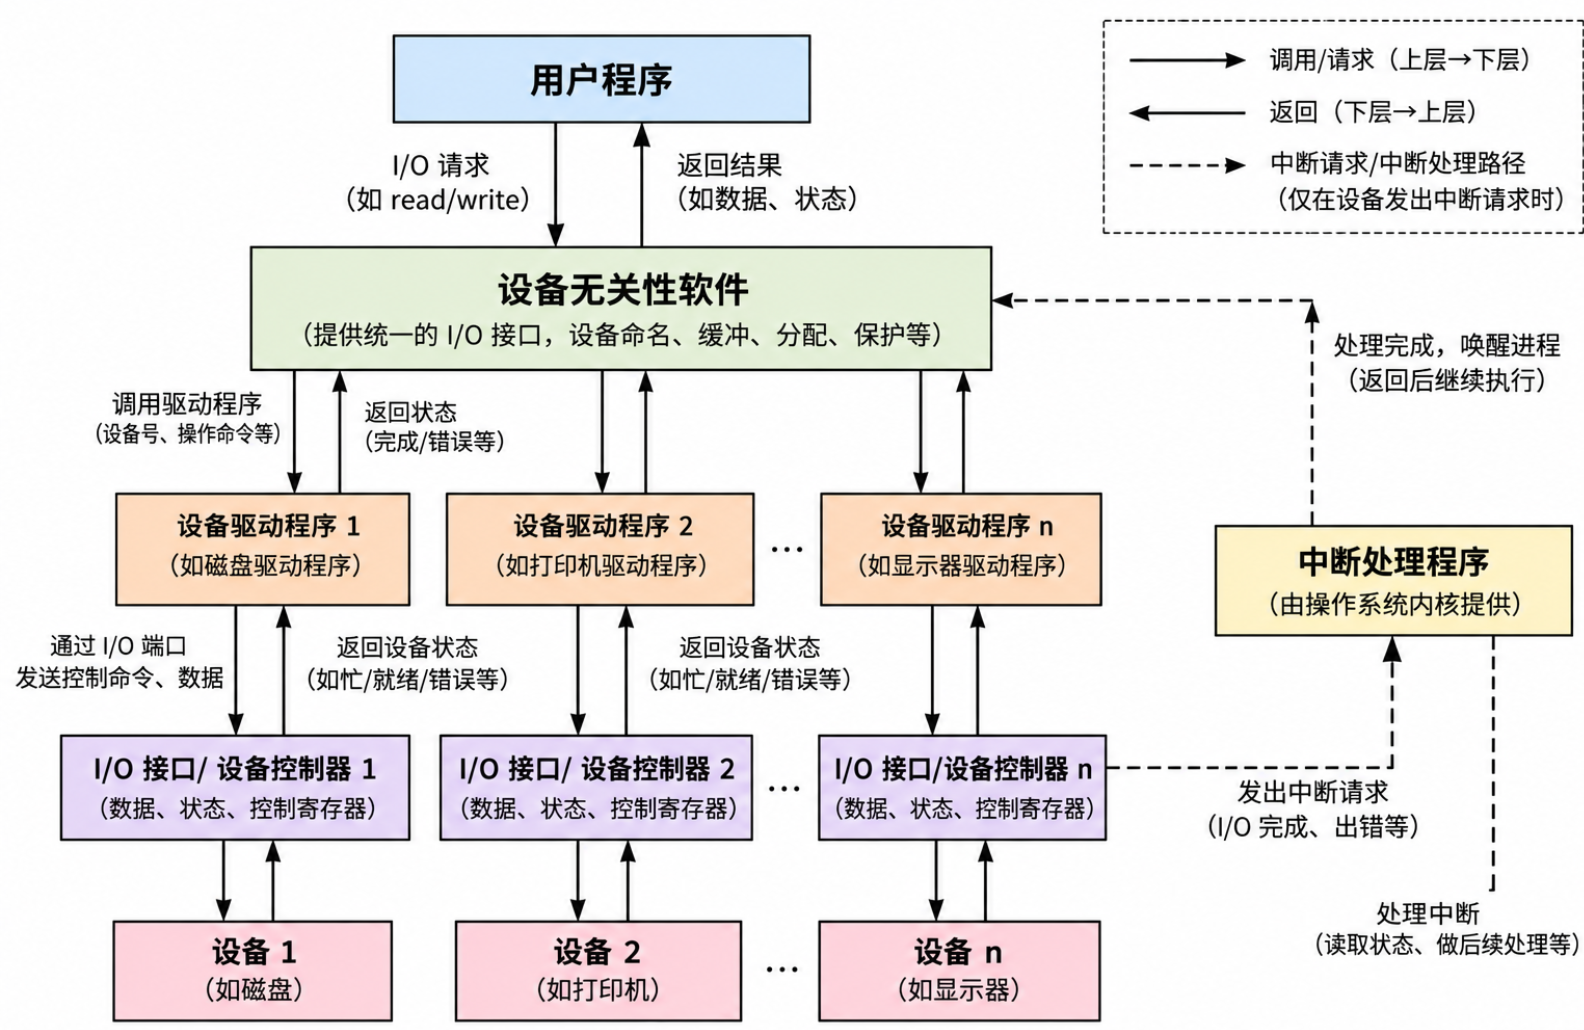
I/O 接口、控制器、适配器与驱动器
- I/O 接口位于 CPU/主存和 I/O 设备之间,负责命令传递、状态反馈、数据缓冲、速度匹配等工作;在 408 中,控制器、适配器通常都可以看作 I/O 接口。以磁盘为例,结构可理解为:
CPU → 磁盘控制器 → 磁盘驱动器 → 磁盘介质,其中磁盘控制器属于 I/O 接口,负责接收 CPU 命令并控制数据传输;磁盘驱动器属于 I/O 设备的硬件执行部分,负责让盘片、磁头等真正完成读写动作,因此它不是 I/O 接口。要注意,驱动器 drive 是硬件,驱动程序 driver 是软件;“驱动器”这个叫法在 408 中主要常见于磁盘、光盘、磁带等存储类设备。 - 驱动程序 = 软件,在控制器上面 控制器 = 硬件,负责控制设备 驱动器 = 具体硬件设备,通常在控制器下面
-
上述的驱动程序就是对应OS中IO分层里的驱动程序。用户程序 -> 设备独立性软件 -> 设备驱动程序 -> 中断处理程序 -> I/O接口(设备控制器) -> 具体设备。
-
设备驱动程序:和具体硬件强相关,负责把 OS 发出的较抽象 I/O 请求,转换成具体设备控制器能执行的命令。
-
设备独立性软件:尽量屏蔽不同设备之间的差异,向上提供统一的 I/O 使用方式,使上层程序不用关心“这是磁盘、打印机还是别的设备”。
-
设备驱动程序和控制器的功能可以理解为两个层次的控制,前者是软件层次,后者是硬件层次。所以考试时看见设备驱动程序控制设备读写等之类的说法是正确的。
- I/O 控制方式由硬件系统所支持的机制决定,设备驱动程序本身不能随意决定采用查询、中断、DMA 等哪种方式,但驱动程序可以针对既定的 I/O 控制方式完成相应的初始化、参数配置和控制。
各寄存器宽度
| 部件/寄存器 | 宽度主要由什么决定 | 如果题目给总线,可以怎么判断 | 核心含义 |
|---|---|---|---|
| MAR | 地址长度 / 主存可寻址单元数 | 通常 MAR 位数 = 地址线根数 | 存放主存地址 |
| PC | 地址长度 | 通常与 MAR、地址线位数一致 | 存放下一条指令地址 |
| MDR | 存储字长、数据通路设计 | 408 常见题中可结合 数据线宽度 判断 | 暂存主存读出/写入的数据 |
| IR | 指令字长 | 与地址线、数据线 没有必然相等关系 | 存放当前指令 |
| ACC | 机器字长 | 不能直接由数据线根数推出 | 存放运算数据/结果 |
| GPR 通用寄存器 | 机器字长 | 不能直接由数据线根数推出 | CPU 内部数据寄存器 |
| ALU | 机器字长 / 运算数据宽度 | 不能直接由数据线根数推出 | 一次能运算多少位数据 |
| SP | 地址长度 | 通常与地址长度有关 | 存放栈顶地址 |
| 基址寄存器 | 地址长度 / 有效地址长度 | 通常与地址长度有关 | 存放基地址 |
| 变址寄存器 | 地址长度 / 有效地址计算需要 | 通常与地址长度有关 | 参与有效地址计算 |
ISA和微指令体系所管辖范围
指令是什么、怎么编码、语义是什么、能访问哪些寄存器、怎么寻址=> ISA
指令怎么取指、译码、流水执行、转发、阻塞、预测=> 微体系结构
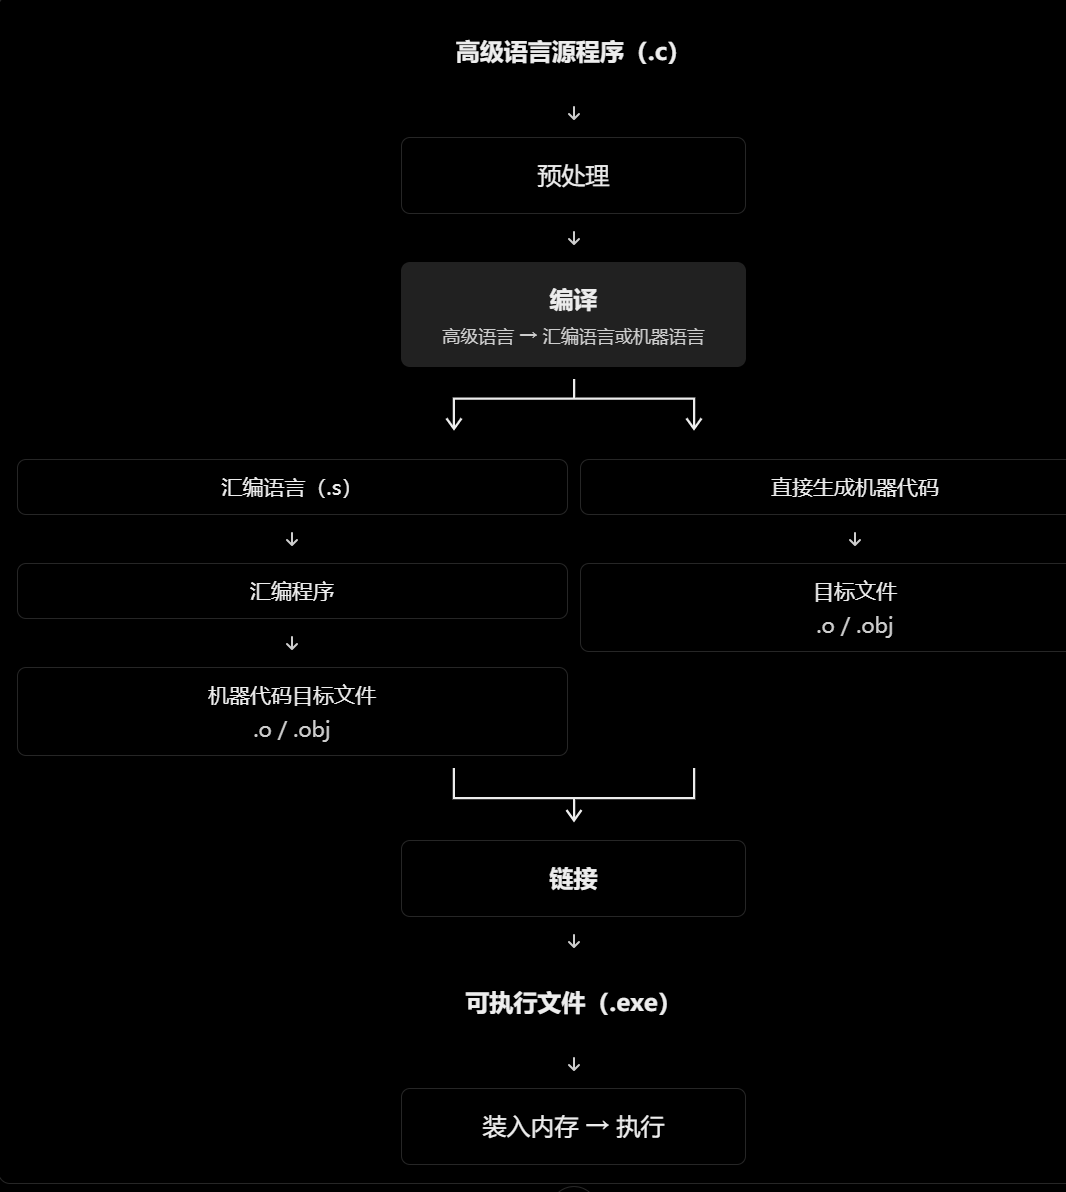
高级语言 -> 可执行目标文件
预处理(将inlude的头文件读入,宏定义等等) -> 编译(高级语言翻译为汇编语言) -> 汇编(汇编语言翻译为机器语言) -> 链接(将多个目标文件以及所需的库文件连接起来,生成可执行文件)
采用硬件阻塞方式处理控制冒险
题中若问及发生流水线阻塞的指令,就算采用硬件阻塞方式处理控制冒险,也算发生流水线阻塞。
Cache与主存、主存与外存
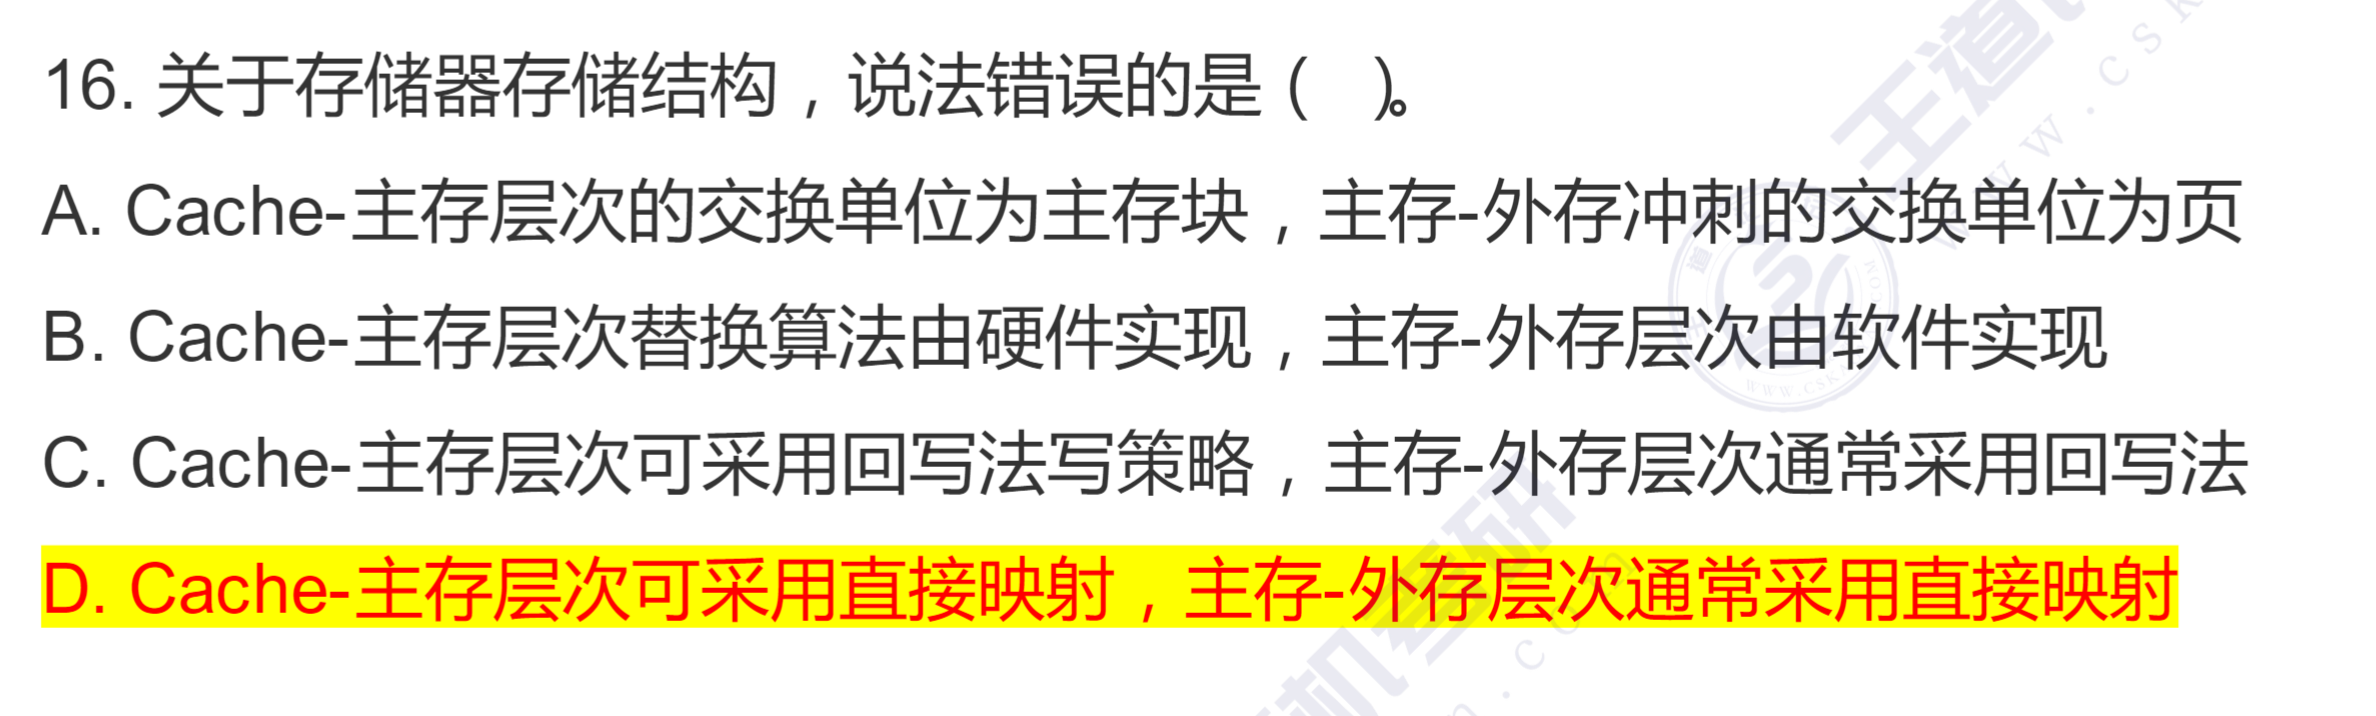
B可以理解为Cache太快了,因此需要硬件来进行替换;对于C,Cache-主存和主存-外存都通常采用回写法;对于D,前半句对,直接映射实现简单,速度快,但是对于访问外存,开销大,所以需要提高命中率,多用全相联或组相联。
通常命中率关系是:
如果只看“查找速度 / 命中判断速度”,一般是:
越自由,冲突越少,命中率越高;但查找时要比较的位置越多,所以越慢。
总线
同步总线与异步总线
- 同步总线并不代表着时钟频率一定等于工作频率,只是用统一时钟规定时序,一个时钟周期内可以传一次数据,多次数据或者若干时钟周期才传一次数据,因此工作频率不一定等于时钟频率。
- 异步总线由握手信号定时,一次握手过程完成一组数据交换。
总线带宽
总线带宽(最大数据传输速率)是理想情况下总线单位时间最多能传多少数据:
\[总线带宽=总线频率\times每周期传输次数\times总线宽度\]
要区分三个概念:
| 概念 | 含义 |
|---|---|
| 总线时钟频率 | 每秒有多少个时钟周期 |
| 总线工作频率(总线频率*每周期传输次数) | 每秒理论上可以进行多少次数据传输 |
| 实际数据传输速率 | 每秒实际传输了多少有效数据 |
总线事务
总线事务是指从总线请求开始,到完成一次总线操作为止的整个过程。
在 408 中,可以这样理解:
- 总线事务:完成一次总线操作的全过程,例如一次总线读或总线写。
- 总线传输:在总线上实际传送数据的过程。
- 总线周期:完成一次总线事务所需的时间(传统总线模型下)。
总线事务是CPU与内存/外设通过总线进行数据交换的过程,其结束是总线操作的自然完成,仅需硬件握手信号确人,无需触发中断请求,不属于中断事件。
DMA控制器控制的数据传输通路
指的是终点和起点,为主存和设备接口
C/C++数据类型转换
在常见的补码机器上,对于整数由低位宽转换为高位宽,可以这样理解:
先按照原数据类型进行扩展,再按照目标数据类型解释。
RSIC和CSIC
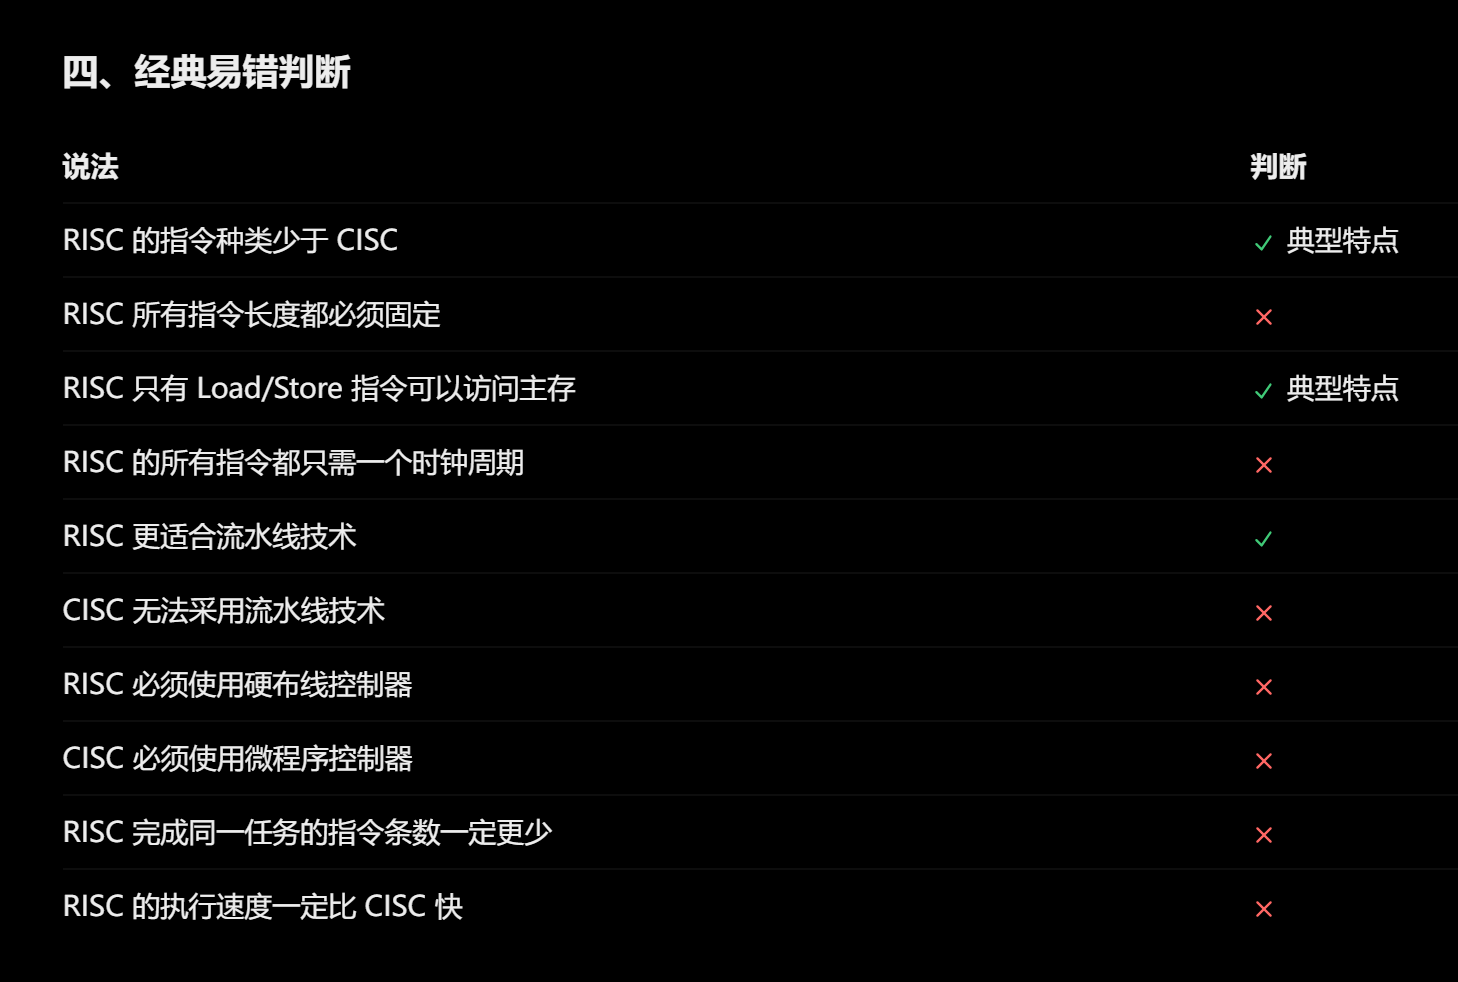
CISC(复杂指令集计算机):指令种类多、功能复杂,一条指令可以完成较复杂的操作。
RISC(精简指令集计算机):指令种类较少、功能相对简单,强调通过简单指令的组合完成复杂操作,便于流水线执行。
RISC 通常只有 Load、Store 指令能够访问主存,算术逻辑运算主要在寄存器之间完成。所以通常需要大量寄存器传递过程调用时的参数。
RISC 常采用硬布线控制,但不是必须;CISC 常采用微程序控制,也不是必须。
Cache索引
严格来说,Cache 索引只包括组号(或行号),不包括块内地址。
具体要看 Cache 的映射方式:
- 直接映射:索引是 Cache 行号。
- 组相联映射:索引是 Cache 组号,不包括组内的路号。
- 全相联映射:没有组索引位。
题中数组在页中、块中偏移量不为0时,一定注意这会影响Cache缺失次数以及缺页次数
进程虚拟地址空间组成
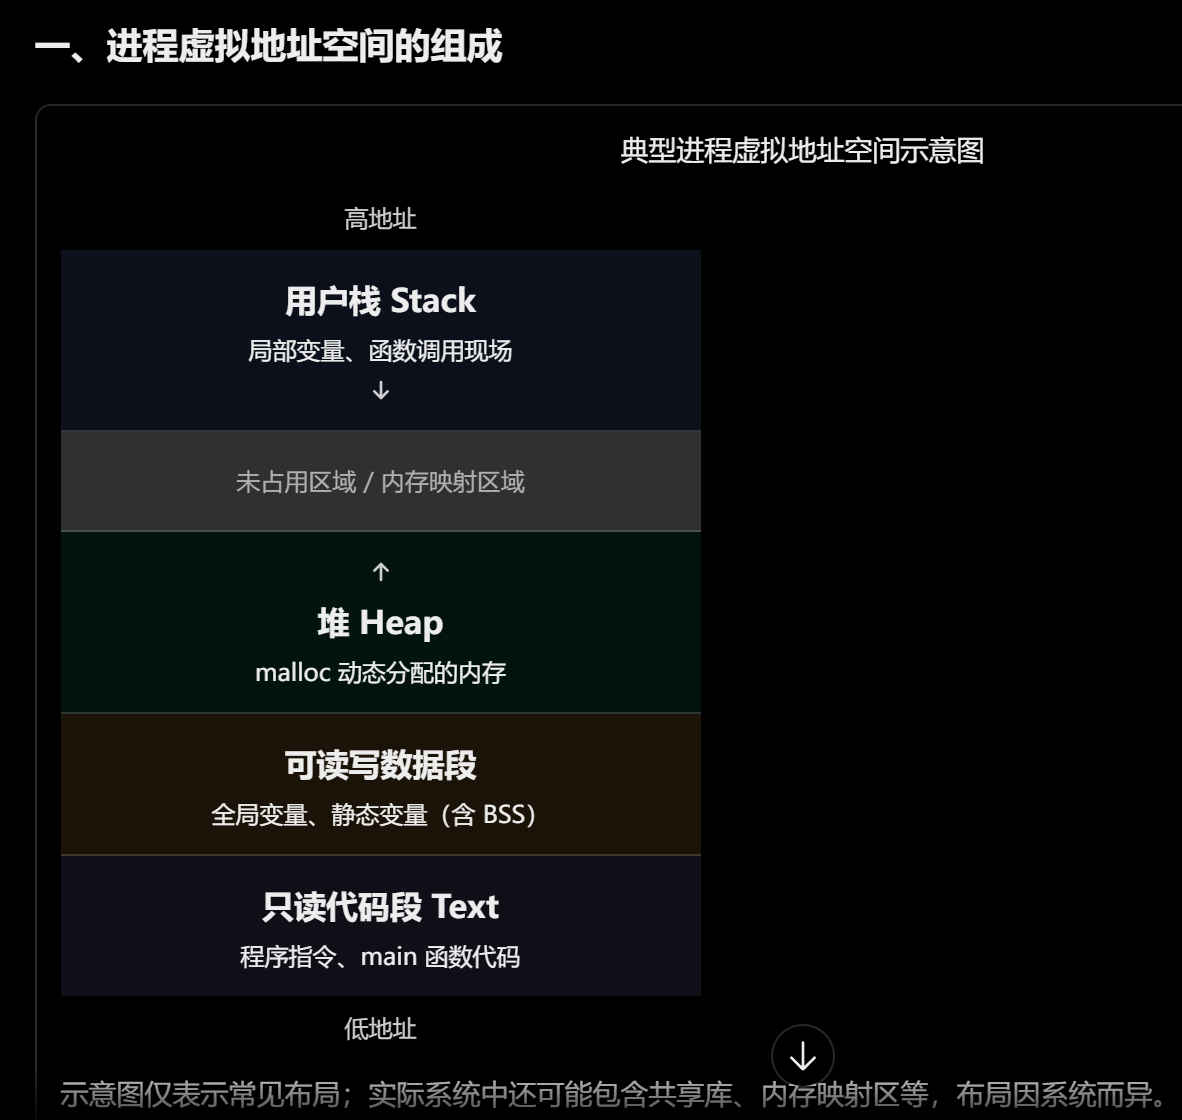
BSS 段(Block Started by Symbol)是程序中用于存放未初始化或初始化为 0 的全局变量、静态变量的内存区域。
多发技术
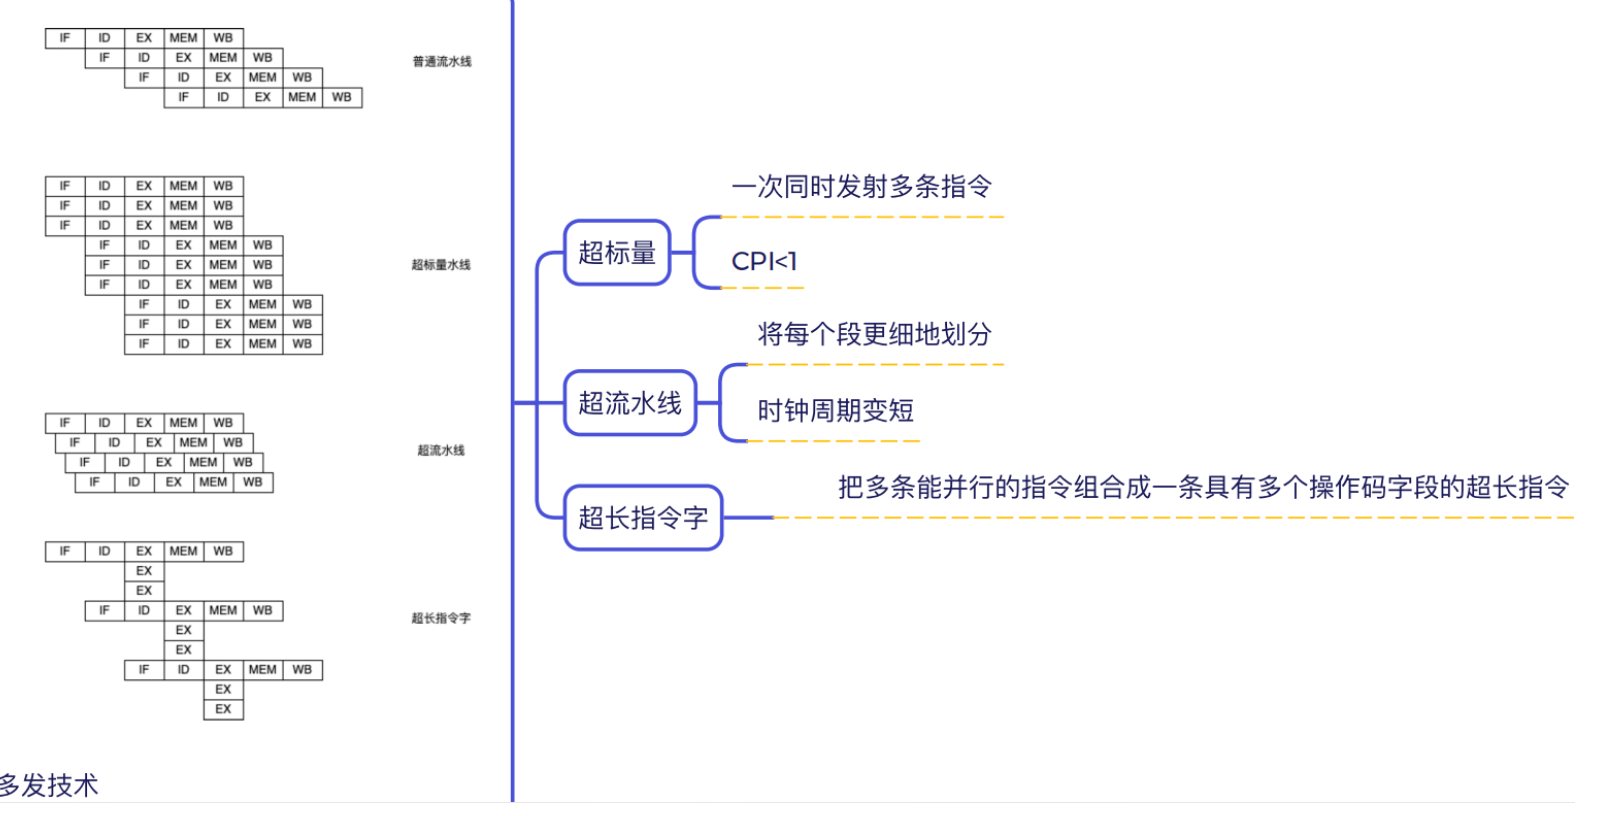
桥接器
- 总线与总线之间:通过桥接器连接。
- 设备与总线之间:通过总线接口连接。
- 桥接器的作用: 连接不同总线,实现速度匹配、数据缓冲和必要的协议转换。
中断请求的产生与当前正在执行指令的关系
内中断:同步,与当前执行的指令有关。
外中断:异步,与当前执行的指令无关。
在 408 考研中,如果题目只说“中断”,没有特别说明,通常默认指外中断。
但不是绝对的,要结合题目语境判断。
单周期多周期
单周期 CPU 与多周期 CPU(408 考点)
| 比较项目 | 单周期 CPU | 多周期 CPU |
|---|---|---|
| 指令执行 | 一条指令在一个时钟周期内完成 | 一条指令需要多个时钟周期 |
| CPI | 恒为 1 | 通常大于 1,不同指令可不同 |
| 时钟周期长度 | 由执行时间最长的指令决定 | 由耗时最长的执行阶段决定 |
| 时钟频率 | 较低 | 较高 |
| 控制信号 | 一个时钟周期内稳定后保持不变 | 随执行阶段逐周期改变 |
| 单总线数据通路 | 不能采用(408 常规模型) | 可以采用 |
| 硬件资源 | 通常需要更多独立硬件,支持并行操作 | 不同阶段可以复用硬件 |
| 控制器 | 通常采用组合逻辑控制 | 通常采用有限状态机控制 |
| 指令执行时间 | 所有指令均占一个相同长度的时钟周期 | 不同指令可能不同 |
| 流水线 | 不采用指令流水线 | 多周期本身不等于流水线 |
注意:
- 单周期 CPU 的控制信号在一个周期内稳定后保持不变,不需要按多个时钟阶段切换。
- 单周期 CPU 不能采用单总线数据通路,是针对 408 常规同步数据通路模型而言。
- 单周期 CPU 的时钟频率通常较低,但 CPI = 1 不代表执行速度一定更快。
工作集
求某时刻的工作集就从该处往前数工作集大小个,然后去重即可。
地址划分与 Cache 映射
就跟虚页号有的时候也分为页目录好和页号,块号也会根据映射方式的不同分为好几部分,如果直接按二进制算的话可以免去很多计算。
能直接被硬件执行的
能够被 CPU 直接执行的语言程序:只有机器语言程序。
能够被硬件直接执行或处理的指令:除了机器指令,还有微程序控制器中的微指令。
Cache 容量计算
核心公式
Cache 数据区容量 = Cache 行数 × 主存块大小
- 一个 Cache 行的数据区存放一个主存块。
- Cache 行的数据区大小 = 主存块大小。
- 计算数据区容量时,不需要考虑 Tag、有效位等附加信息。
数据区容量与总容量的区别
| 比较项 | Cache 数据区容量 | Cache 总容量 |
|---|---|---|
| 数据块 | 包含 | 包含 |
| Tag(标记位) | 不包含 | 包含 |
| 有效位、脏位等 | 不包含 | 包含 |
| 计算方法 | 行数 × 块大小 | 行数 × 每行总位数 |
易错点
- 主存块大小 = Cache 行的数据区大小,不等于 Cache 行的总大小。
- Cache 的映射方式影响标记位等信息的位数,但不改变已知行数和块大小下的数据区容量。
- 计算 Cache 总容量时,必须考虑题目规定的标记位、有效位等开销。
记忆:求数据区容量,直接行数 × 块大小;求总容量,还要加标记位和状态位。
磁盘内数据的修改
读出来到内存中,在内存中修改,修改完后写回磁盘。这一共算两次访问磁盘。
DMA响应时机与中断IO方式
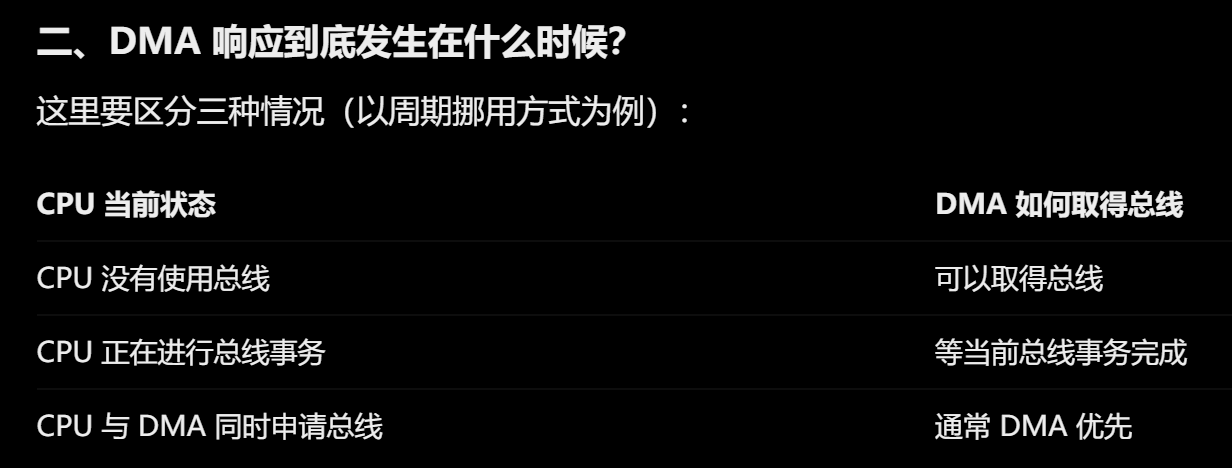
中断IO方式下数据传送通过软件完成。这句话是正确的,当然整个过程中也需要硬件参与。这里的软件指的是设备驱动程序中的中断服务程序。
多体交叉存储器、Cache 与 CPU 执行时间
高位交叉编址与低位交叉编址
| 对比 | 高位交叉编址 | 低位交叉编址 |
|---|---|---|
| 存储体编号 | 地址高位决定 | 字地址低位决定 |
| 连续地址 | 集中在同一个存储体 | 依次分布在不同存储体 |
| 连续访存 | 通常需要等待同一存储体 | 可交叉并行访问 |
| 特点 | 适合存储体相对独立工作 | 适合连续、批量数据传送 |
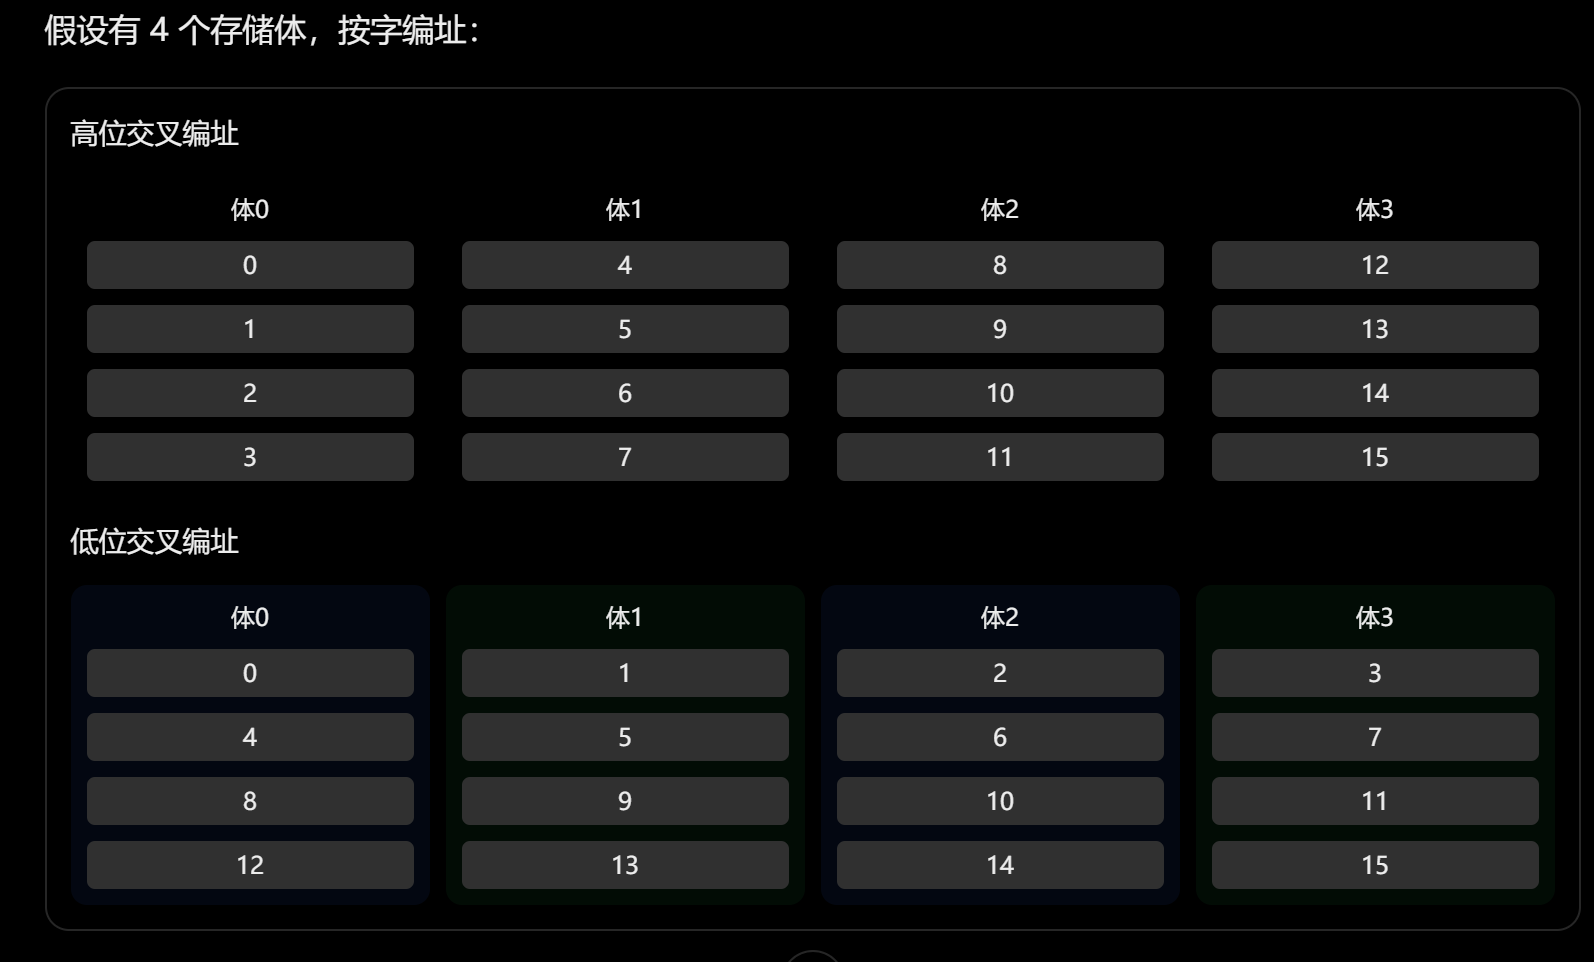
记忆:高位交叉连续地址集中,低位交叉连续地址分散。
多体交叉存储器的访问时间
设存储周期为 \(T\),存储体数量为 \(m\)。
理想情况下,连续交叉访问的最小启动间隔:
\[\boxed{\Delta t=\frac{T}{m}}\]
理解: - 存储周期:同一存储体两次启动存取操作的最小间隔。 - 多个存储体轮流启动,再次轮到第一个存储体时,恰好经过一个存储周期。 - 多体交叉提高吞吐率,并没有缩短单个存储体的存储周期。 - 实际启动间隔还受总线周期、存储器接口等条件限制。
突发传送时间(流水线)
一次读突发传送:
传送地址和命令 → 等待首个数据准备完成 → 连续传送数据
在连续数据能够交叠准备、总线能够持续传送的条件下:
\[\boxed{T_{\text{总}}=T_{\text{地址}}+T_{\text{首字准备}}+T_{\text{数据传送}}}\]
后续存储字的准备过程可以与前面的数据传送重叠,不必对每个存储字重复计算完整存储周期。
平均访存次数与 Cache 缺失
CPU 访存包括取指访存和数据访存,因此一条指令可能多次访存。
\[\boxed{\text{总访存次数}=\text{指令条数}\times\text{平均每条指令访存次数}}\]
访存不一定意味着实际访问主存: - 不考虑 Cache:访存通常直接理解为访问主存。 - 考虑 Cache:CPU 访存通常先查询 Cache,命中直接返回,缺失才需要访问主存取块。
\[\boxed{\text{缺失次数}=\text{总访存次数}\times\text{Cache缺失率}}\]
注意:Cache 缺失率针对访存次数,不一定针对指令条数。
CPI 与 CPU 执行时间
CPI:平均每条指令所需的 CPU 时钟周期数。
- CPU 执行指令包括取指、译码、执行、访存等操作,并不只是计算。
- CPU 执行时间包含因 Cache 缺失产生的 CPU 停顿时间。
- 基础 CPI(Cache 全命中)包含正常 Cache 访问开销。
- 实际 CPI 还可能包含 Cache 缺失等导致的停顿周期。
\[\boxed{\text{实际CPI}=\text{基础CPI}+\text{平均额外停顿周期}}\]
CPU 执行时间的计算
当题目给出 Cache 全命中时的 CPI 和 Cache 缺失损失时间时:
\[\boxed{T_{\text{CPU}}=N\times CPI\times T_c+N\times a\times f\times P}\]
| 符号 | 含义 |
|---|---|
| \(N\) | 指令条数 |
| \(CPI\) | Cache 全命中时的基础 CPI |
| \(T_c\) | CPU 时钟周期 |
| \(a\) | 平均每条指令访存次数 |
| \(f\) | Cache 缺失率 |
| \(P\) | 每次缺失的额外损失时间 |
理解:基础执行时间 + Cache 缺失额外开销。
基础 CPI 已包含正常 Cache 命中时间,不能重复计算。
Cache 缺失时间是否包含命中时间
| 题目表述 | 理解 |
|---|---|
| Cache 缺失损失时间(Miss Penalty) | 相对于正常命中额外增加的时间 |
| Cache 缺失时的总访问时间 | 包含正常 Cache 查询及缺失处理时间 |
| Cache 全命中时的 CPI | 已包含正常 Cache 访问开销 |
| 主存访问时间 | 仅说明主存操作时间,是否额外计入取决于题目模型 |
平均访存时间可以写成:
\[\boxed{AMAT=T_{\text{命中}}+f\times P}\]
也可以写成:
\[\boxed{AMAT=(1-f)T_{\text{命中}}+fT_{\text{缺失总时间}}}\]
注意: - 缺失损失可能包括主存读取、脏块写回、Cache 填充等开销。 - 区分“额外损失时间”和“缺失时的总访问时间”,避免重复计时。
冷知识
- 寄存器未赋值也会有某种二进制的组合,因此取反不会有问题。