排序
排序
考点一 内部排序思想
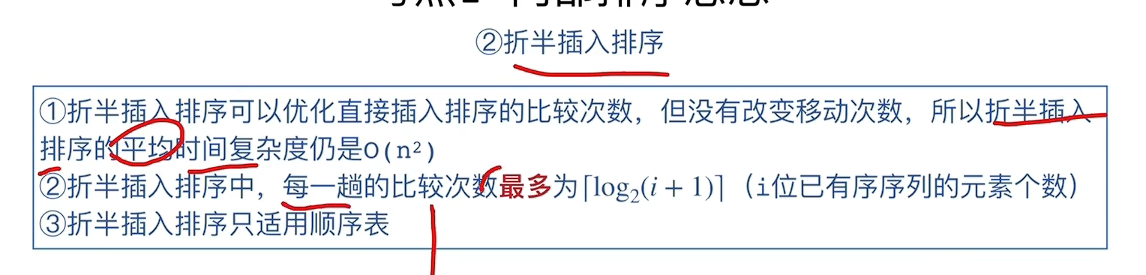
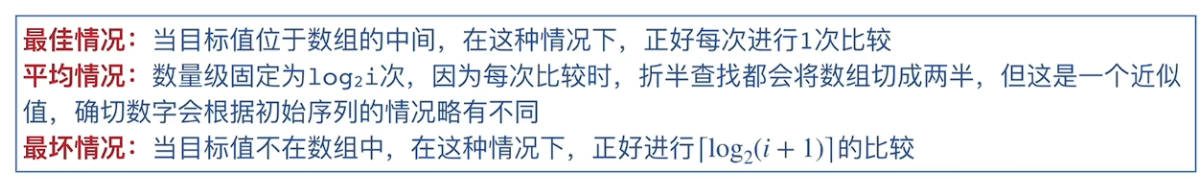
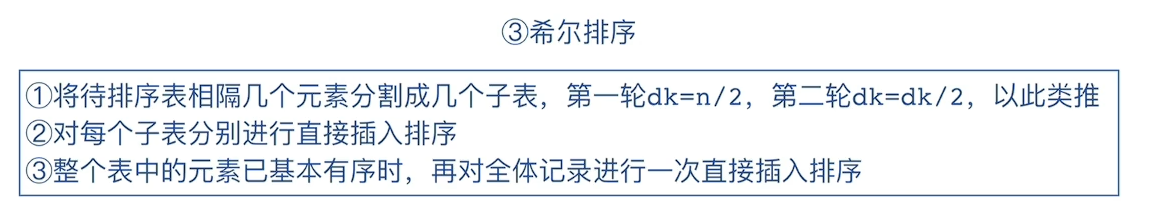
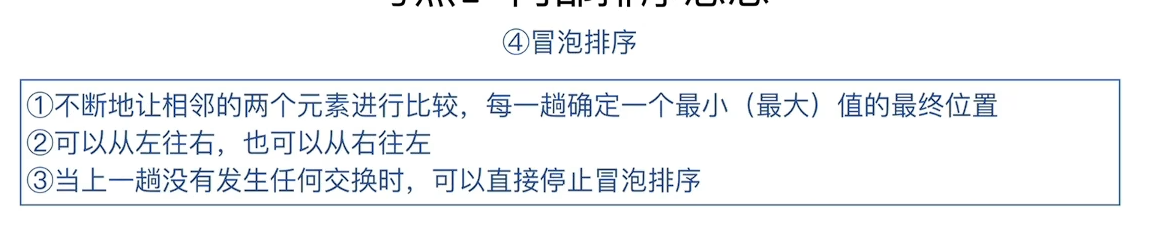
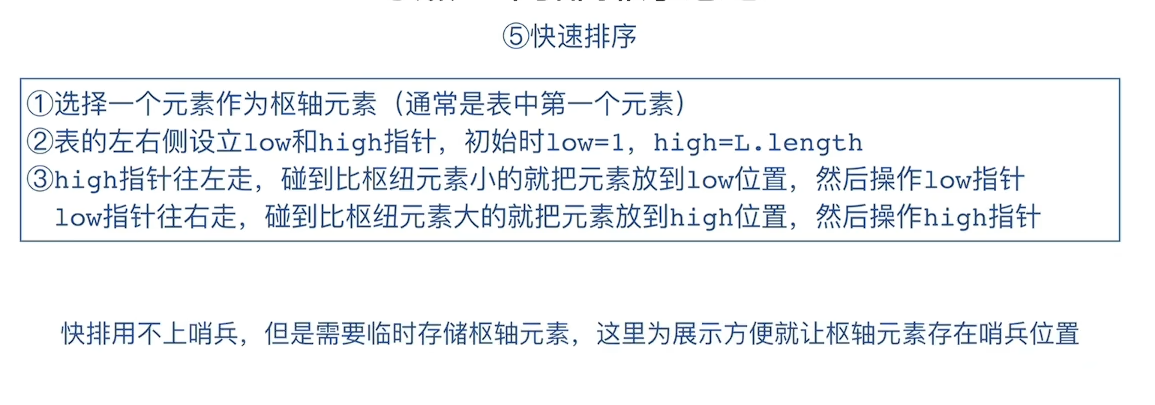
下图仅对于手算而言:(pivot是上图的枢轴)
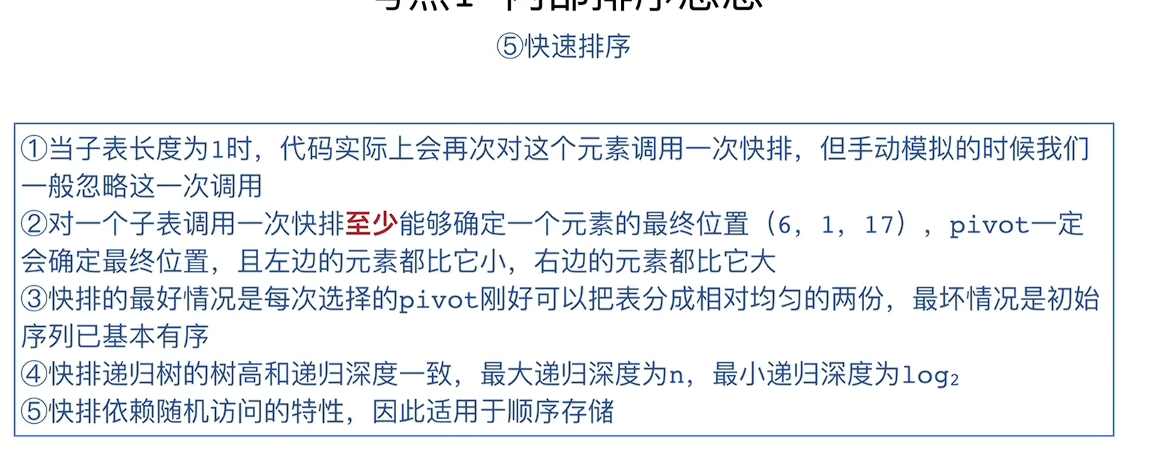
快排初始序列如果基本有序,那么每次选的枢纽能分出来的子表就少,树深也就越深。
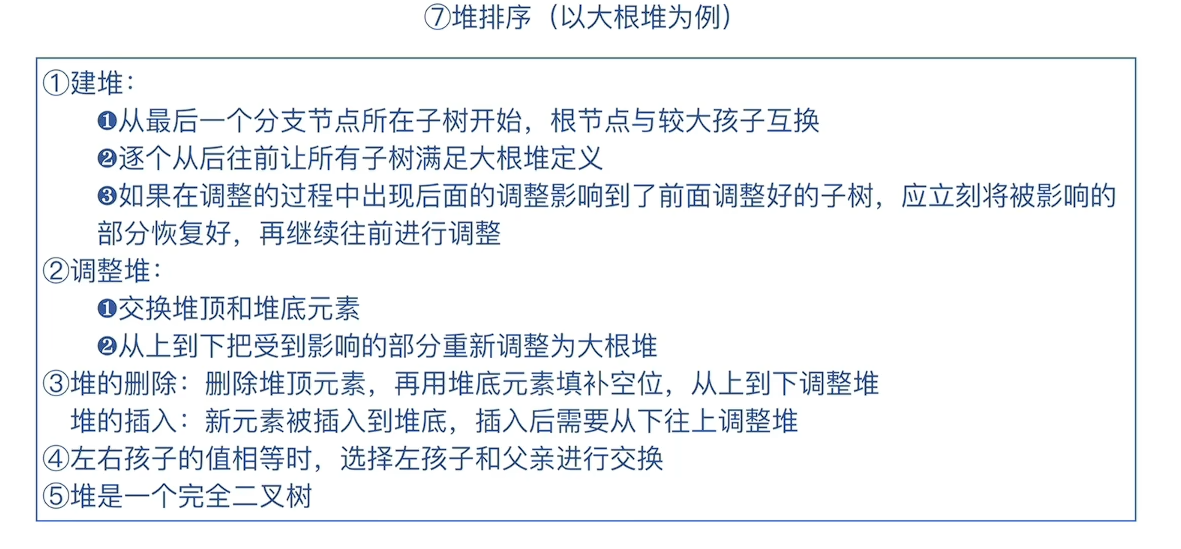
!!!这里注意!!!堆的插入不需要和兄弟结点进行比较,因为兄弟本来就上不去,所以只需要让插入节点和父结点进行比较即可;只有删除和建堆的时候需要和兄弟比较了再和父结点比较。
考点二 内部排序总结
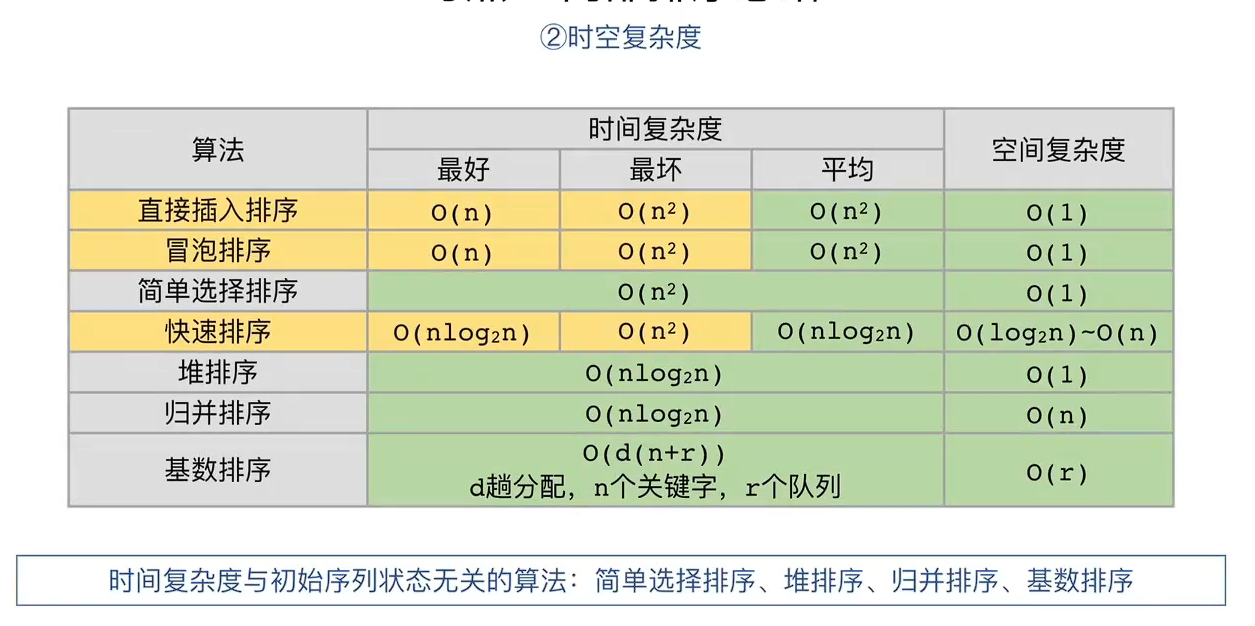
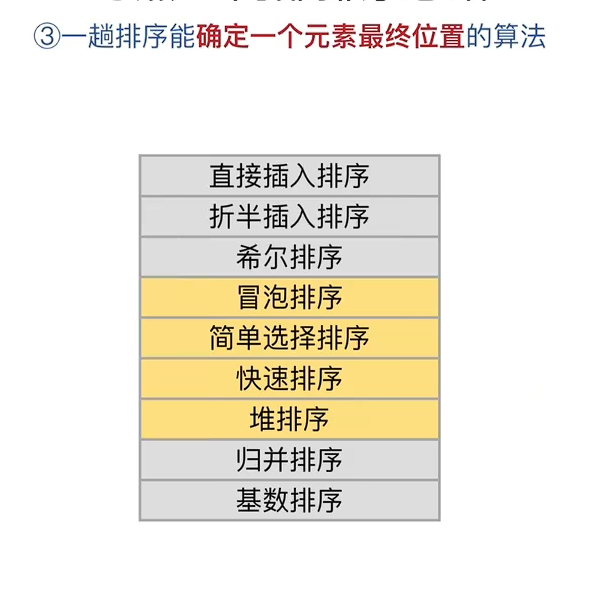
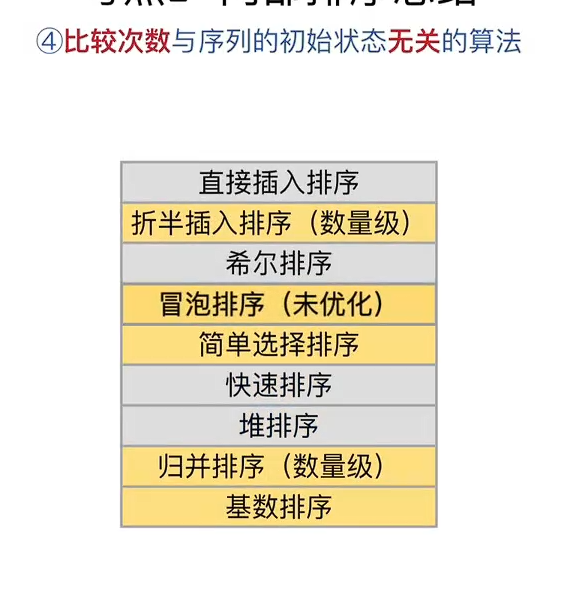
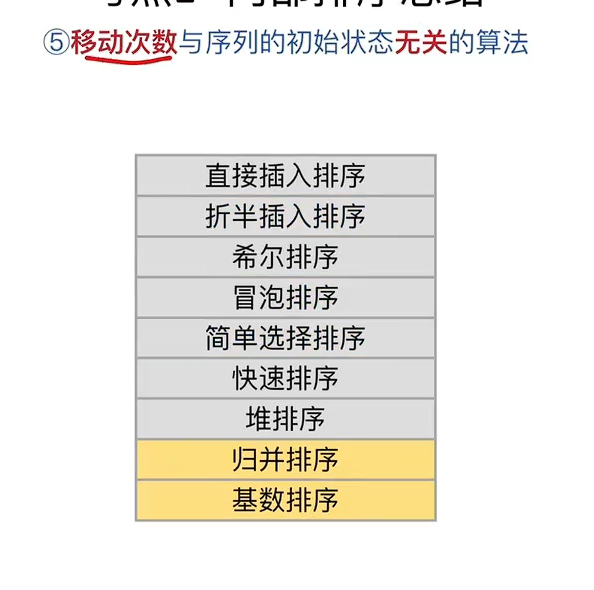
上图中,归并排序需要一个辅助数组,无论元素是否有序都会往辅助数组里暂时存储元素,因此无关。基数排序则是需要队列进行存取。
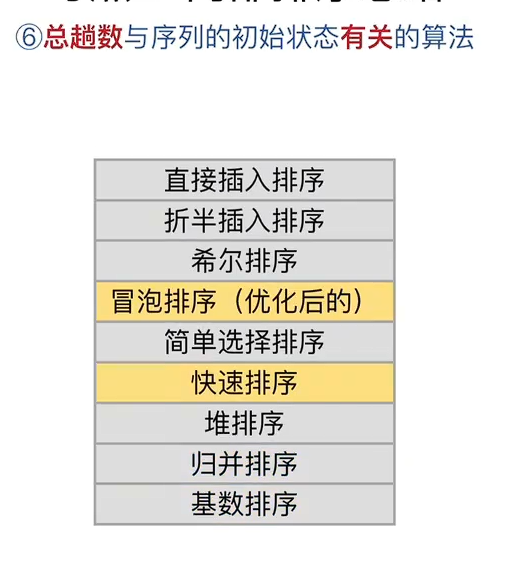
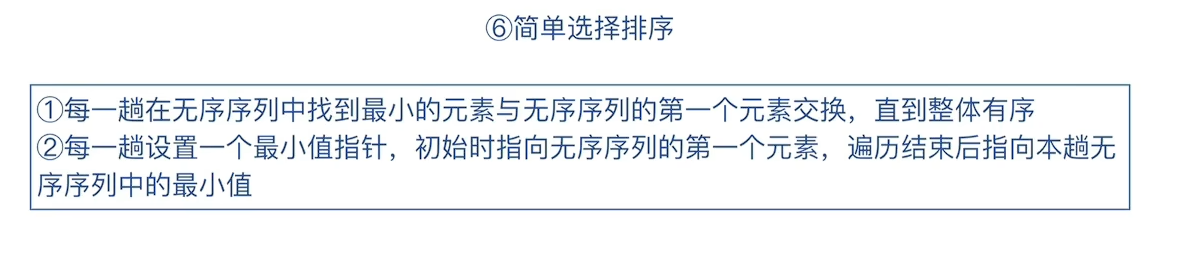
上图堆排序对应的是调整堆
考点三 外部排序
-
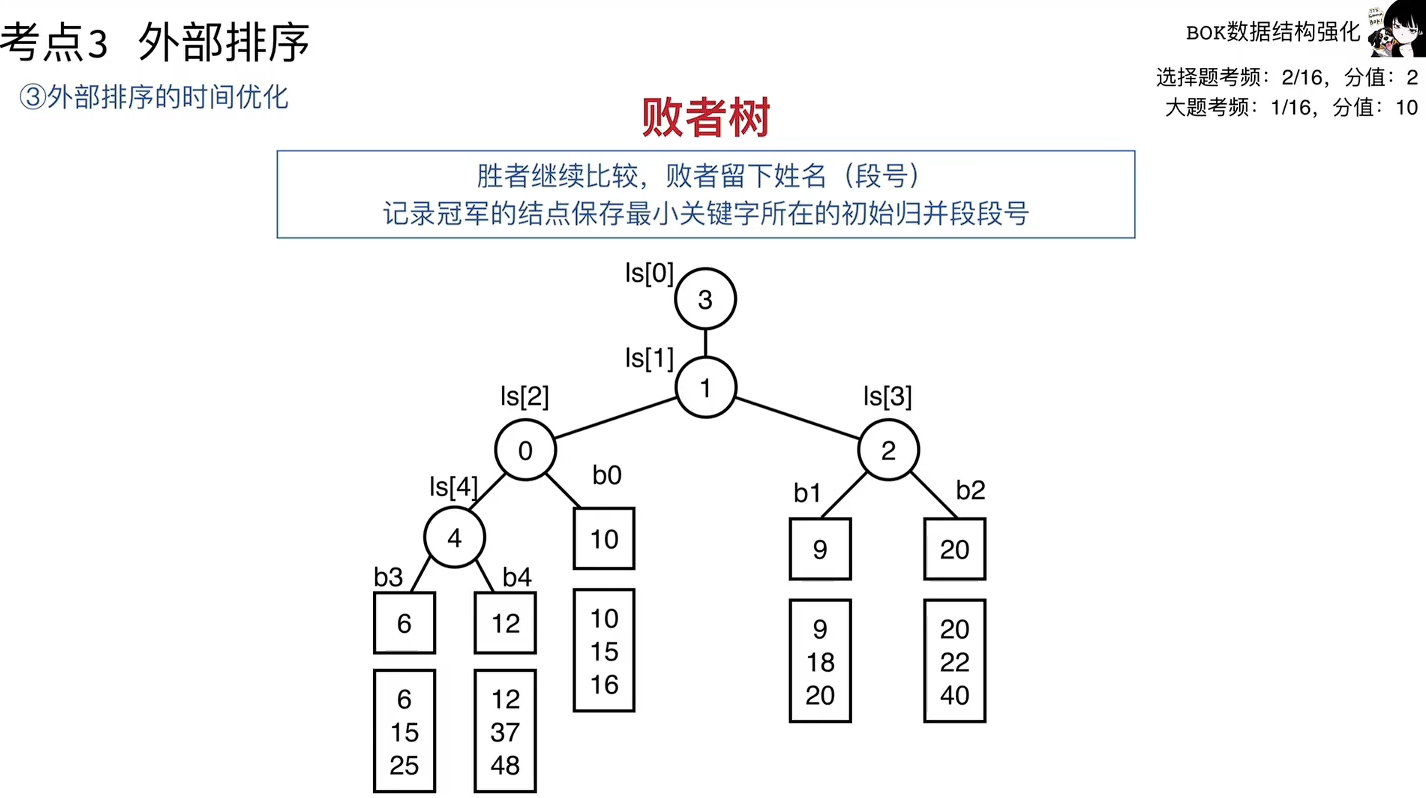
败者树是一棵二叉树。k路归并树是k叉树,败者树是用来快速取得k个段中下一个该放的元素,以快速完成k路归并。败者树是不显示的,在明面上的是k路归并树。
-
构建败者树时,假设初始k个归并段,根据n0 = n2 + 1,就有k - 1个非叶节点需要填充,也就是决出k - 1个败者,就需要k - 1次比赛(比较)。
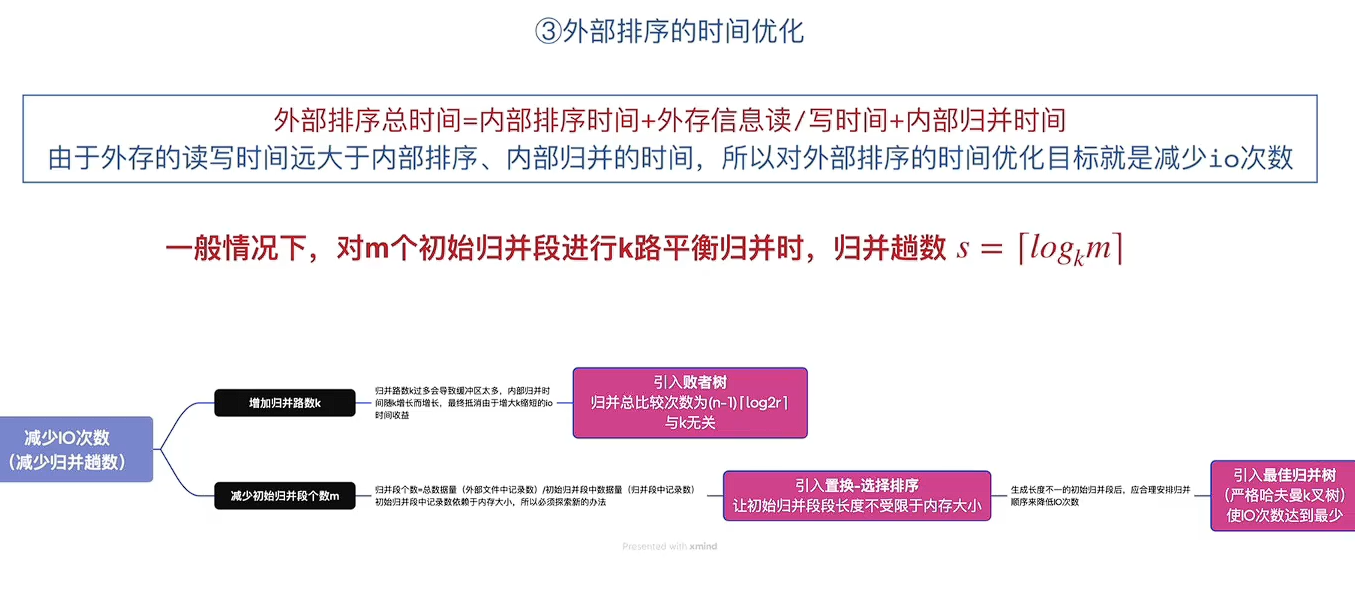
- 败者树调整的总比较次数与归并路数无关,与树高有关。
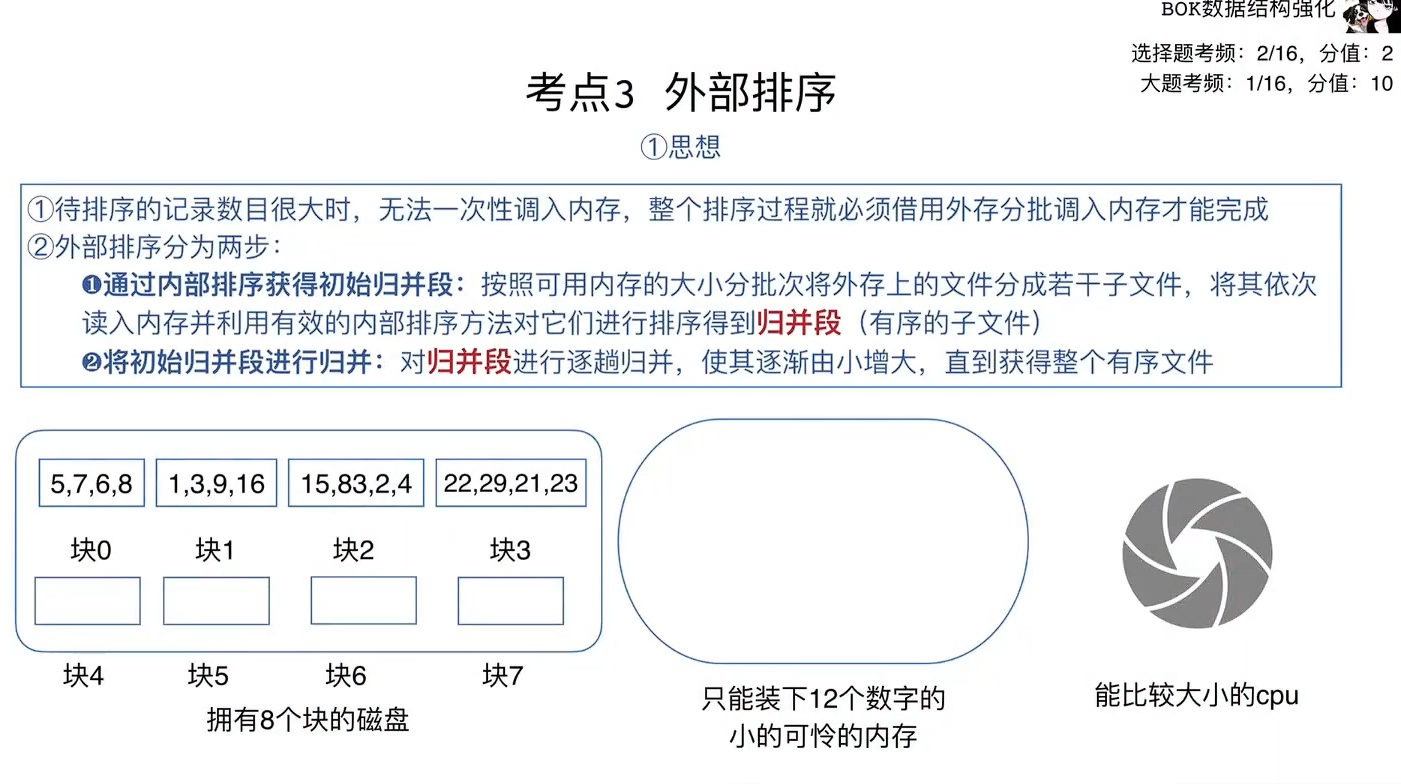
阶段一:生成初始归并段(拆散)
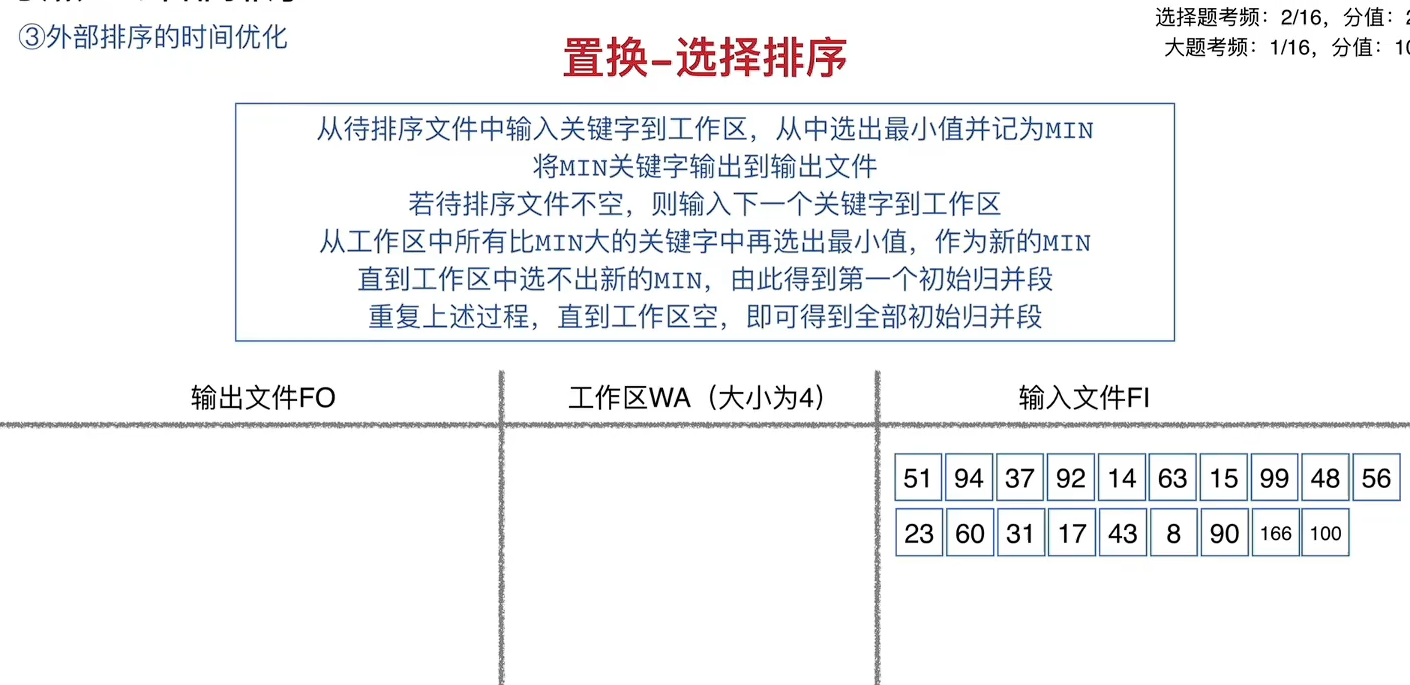
- 拆分与内部排序:把磁盘上的大文件,每次读一部分到内存里(比如每次读 1GB)。在内存里用我们熟悉的快速排序、堆排序等方法把这部分数据排好序。
- 写回磁盘:把排好序的这 1GB 数据写回磁盘,形成一个有序的“小段”。这个“小段”在 408 中被称为初始归并段。
- 循环这个过程,直到所有数据都被切分并排好序。
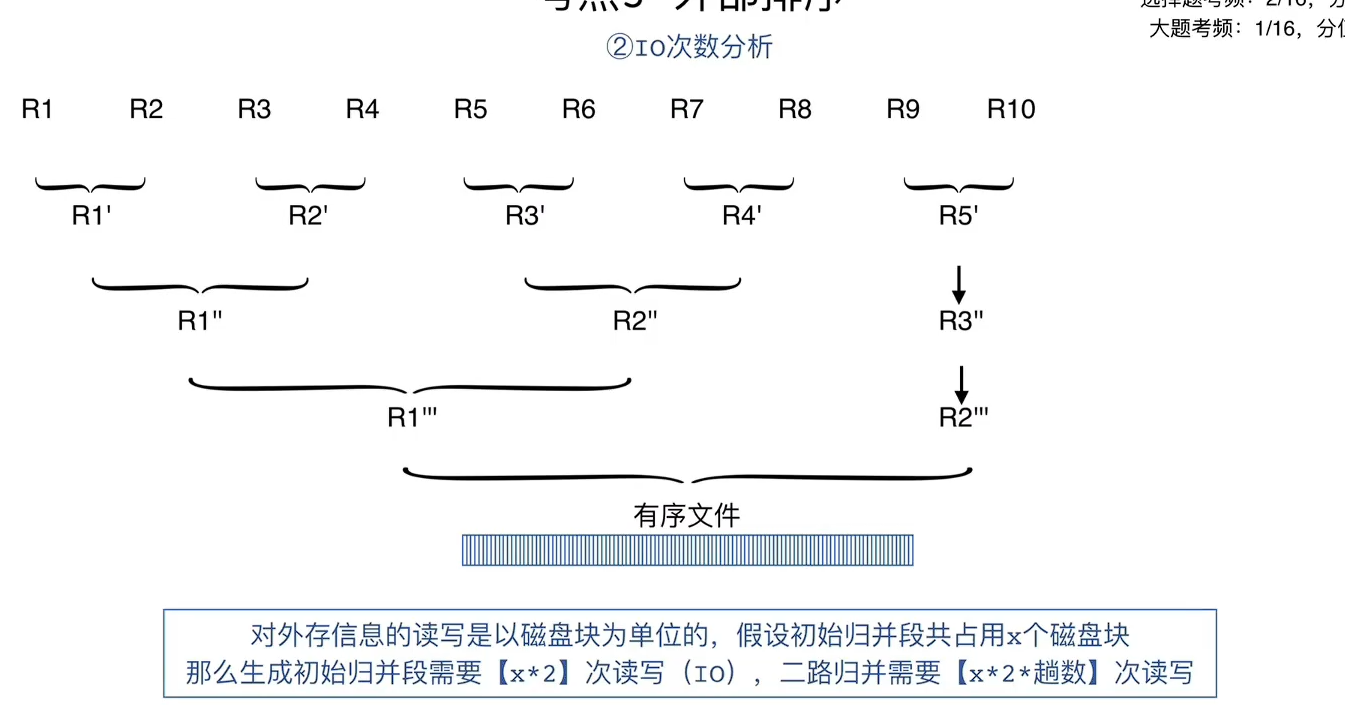
阶段二:多路归并(合并)
这是败者树发挥作用的地方。现在磁盘上有很多个有序的小段(归并段),我们需要把它们合并成一个完整的大有序文件。
假设我们现在要进行 \(k\) 路归并(即同时把 \(k\) 个小段合并在一起):
- 各出一个代表:从磁盘上拿出这 \(k\) 个归并段的第一个元素(也就是每个段里最小的元素),放到内存里。
- 找最小值:在这 \(k\) 个代表元素中,找出最小的那一个。
- 输出与替补:把找出的这个全局最小元素写入到最终的输出文件中。因为这个元素被拿走了,所以它所在的那个归并段,要顺次把下一个元素读进内存来“替补”。
- 循环往复:重复步骤 2 和 3,直到所有的归并段都被读完。
为什么在“合并”阶段需要败者树?
问题就出在步骤 2(找最小值)*和*步骤 3(替补后再次找最小值)。
在合并的过程中,归并段是预先排好序的,这没错。但是,当我们从 \(k\) 个归并段里各拿出一个元素(一共 \(k\) 个元素)来找最小值时,这 \(k\) 个元素之间是无序的。
就像我们刚才讨论的,如果每次替补上来一个新元素,你都用最朴素的方法去和剩下的 \(k-1\) 个元素重新打一遍擂台,每次都要比较 \(k-1\) 次,这个效率太低了。
败者树就是在这个“合并”阶段插进来的一个“作弊器”:
- 没有败者树时:每次合并输出一个数,都要进行 \(k-1\) 次枚举比较。
- 有败者树时:因为败者树记住了之前比较的结果(败者留在结点里),新替补上来的元素不需要和所有人比,只要沿着树干和历史上的“败者”比就行了,比较次数直接降到了 \(\lceil \log_2 k \rceil\) 次。