数据的表示与运算
数据的表示与运算
编码
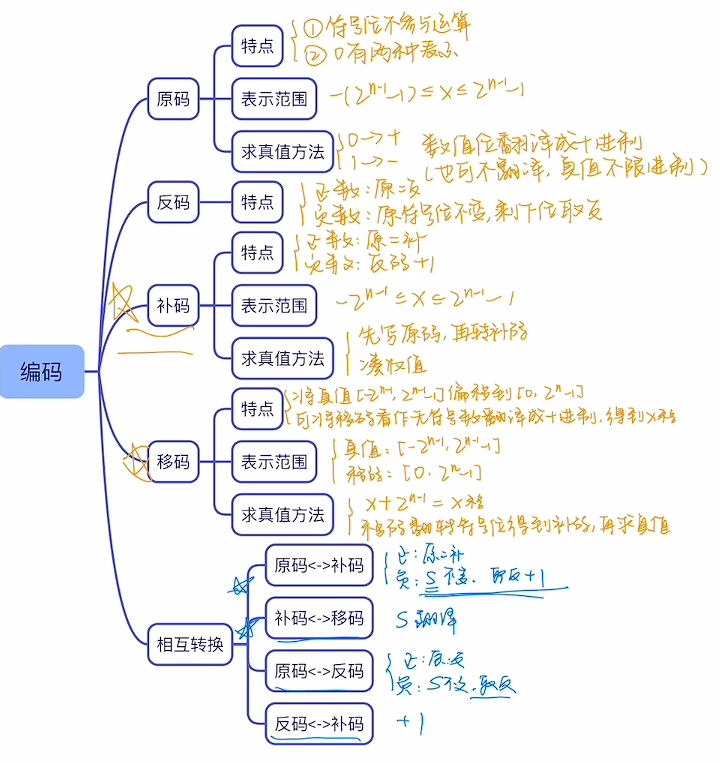
- 对于补码转真值(技巧,速算):
注意!!仅针对负数补码可用
最高位代表负号的 1 当作数算,但是要加上一个负号,加上后面的 1 代表的权值之和。
如:
1101 -> -2^3^ + 2^2^ + 2^0^ = -3。
同理,如果要求移码对应的真值也可以通过反转最高位得补码后根据上述方法求出真值。配合下面的符号扩展,可以进一步加速。
- 若字长为 n 位,移码偏置值通常取 2^n-1^,因此取值范围就是补码取值范围基础上加上偏置值。
- 0x什么什么是优先往前补0,除非填不下了。如0xff指的是0000 00FFH;0xffff ffff指的是FFFF FFFFH。
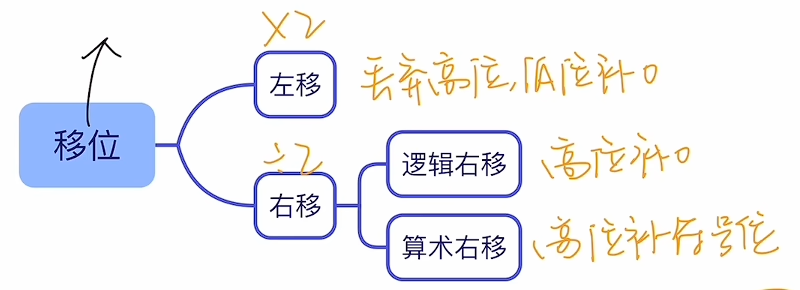
移位
符号扩展
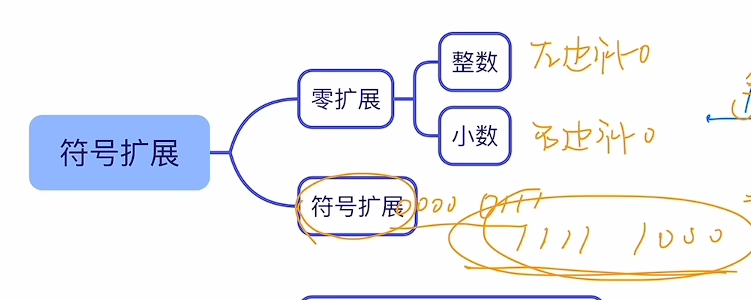
不难发现,如果一个负数的补码需要给他补符号位,那么一定是往前补 1。在题目中也经常见到前面一堆 1,F 的,如何快速算出真值? 从最高位开始找到第一段连续的 1,删到只剩这一段内最低位的 1,再通过上述方法快速求出真值,如
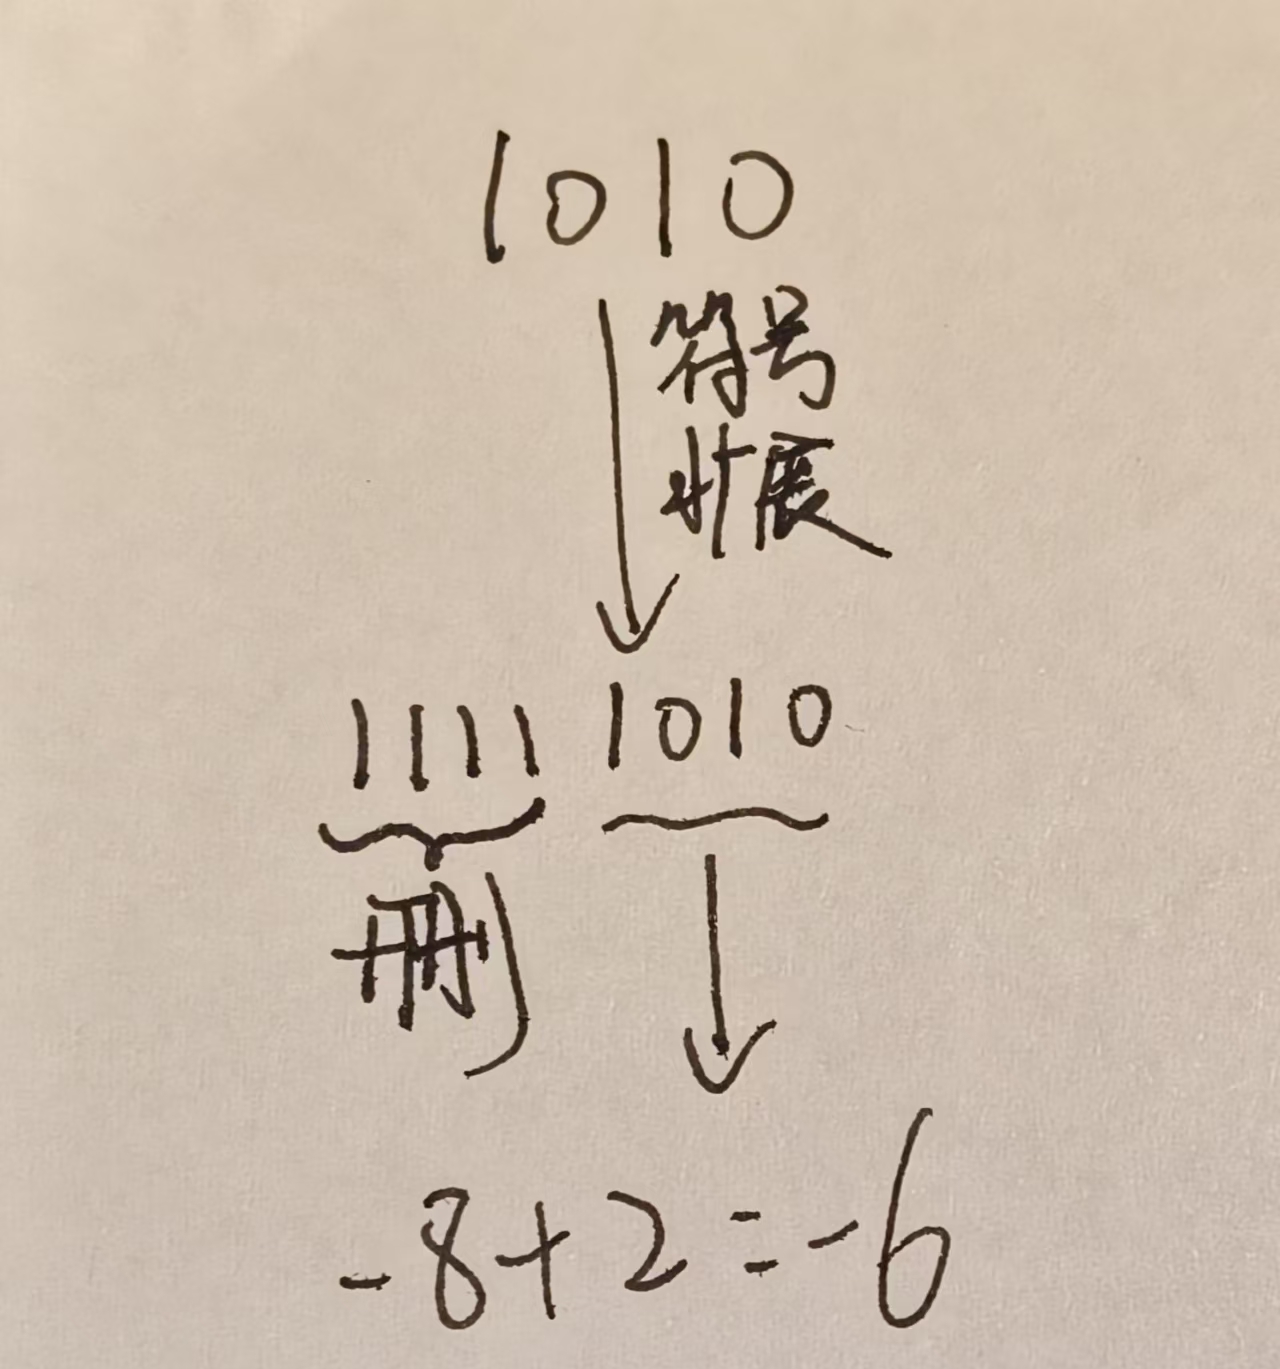 当然,这种技巧也有不好算的时候,这个时候就用一般方法转原码算好了
运算部件
定点数的加减法
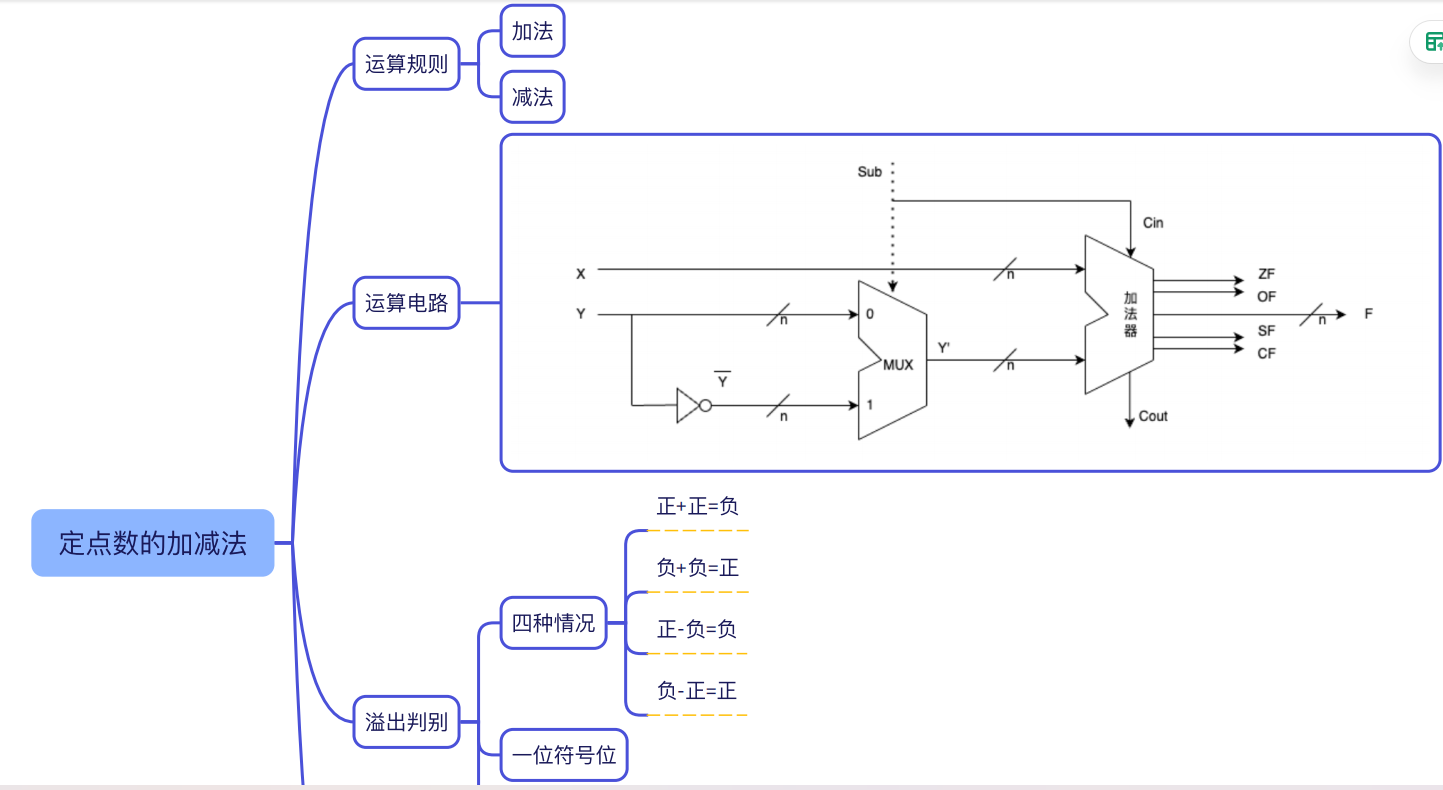
- 如何求-y 的补码:所有位(包括符号位)取反加 1
- 对运算电路的详细描述:求解X op Y的结果,Y进来后会进入到两根线里,最下面的那根线会对Y进行取反操作,然后多路选择器MUX通过Sub信号,确定op是‘+’ or ‘-’,分别对应0,1。这之后将要输出的端口送到加法器,可以看到Cin是最低位进位,注意,此处的最低位进位指的不是第0位相加后产生的进位,而是从外部输入的,让Cin也参与运算,这也对应了上一条笔记。
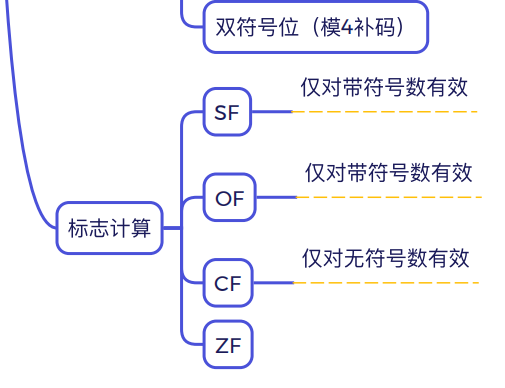
- \(OF = C_{n} \oplus C_{n-1}\)(最高位进位和次高位进位)
- \(CF = C_{out} \oplus C_{in}\)(最高位进位和最低位进位;最低位进位也是Sub信号)
- CF是无符号溢出标志,算出来的数就算是正数也不一定是没溢出,比如1 - 2
- 由溢出判别的四种情况我们可以得出逻辑表达式:\[OF = A_s B_s \bar S_s + \bar A_s \bar B_s S_s\]
正 + 正 = 负 || 负 + 负 = 正;对于另外两种情况都是减法,会转化成加法
- 双符号位就是正数符号位是00,负数是11,最终两个符号位不相等就代表溢出,正溢是01,负溢是10
浮点数
一般情况
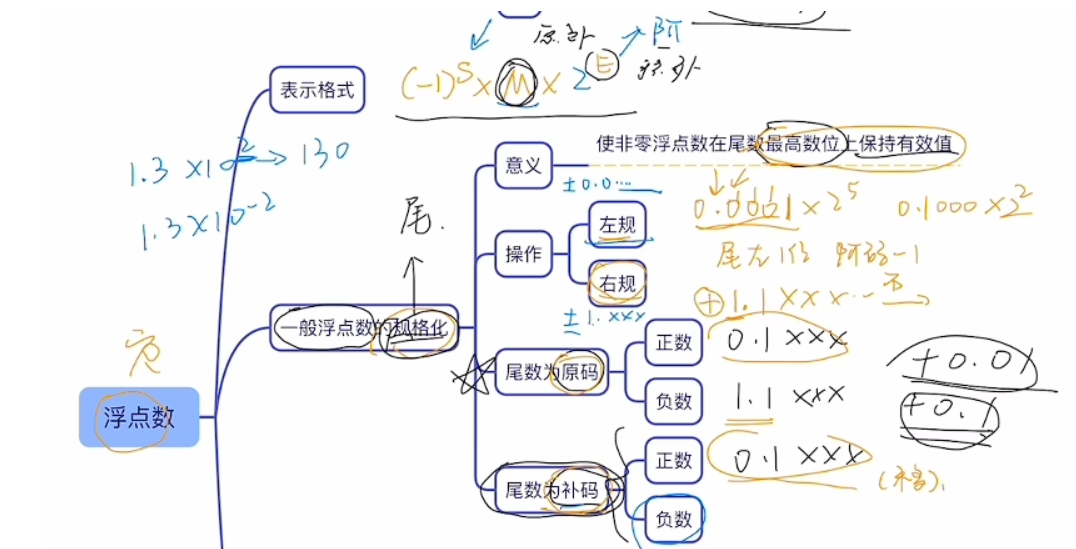
- SME,符号、尾数、阶码
- 浮点数尾数规格化的根本目的,是为了不浪费高位的存储空间,尽可能多地保留有效数字。
- 通常来说尾数是用原码来表示的,小数点前第一位是符号位,所谓的最高数位其实就是小数点后第一位,规格化就是让最高数位为1,让他是个有效数字。
- 尾数用补码表示时规格化为:正数0.1xxx、负数1.0xxx。原因:在补码算真值处,我们把符号位也当作数值位,这里也是同理,小数点前第一位同时承担着符号位和数值位的功能。正数好理解,因为补码和原码是一致的;对于负数来说,为了表示更多的数字,如果是1.1xxx的话,就是-1 + 0.5 = -0.5和1.0xxx相比,-1离0更远,表示的数更多。
- 与非规格化浮点数相比,采用规格化浮点数的目的主要是为了增加数据的表示精度。
IEEE 754
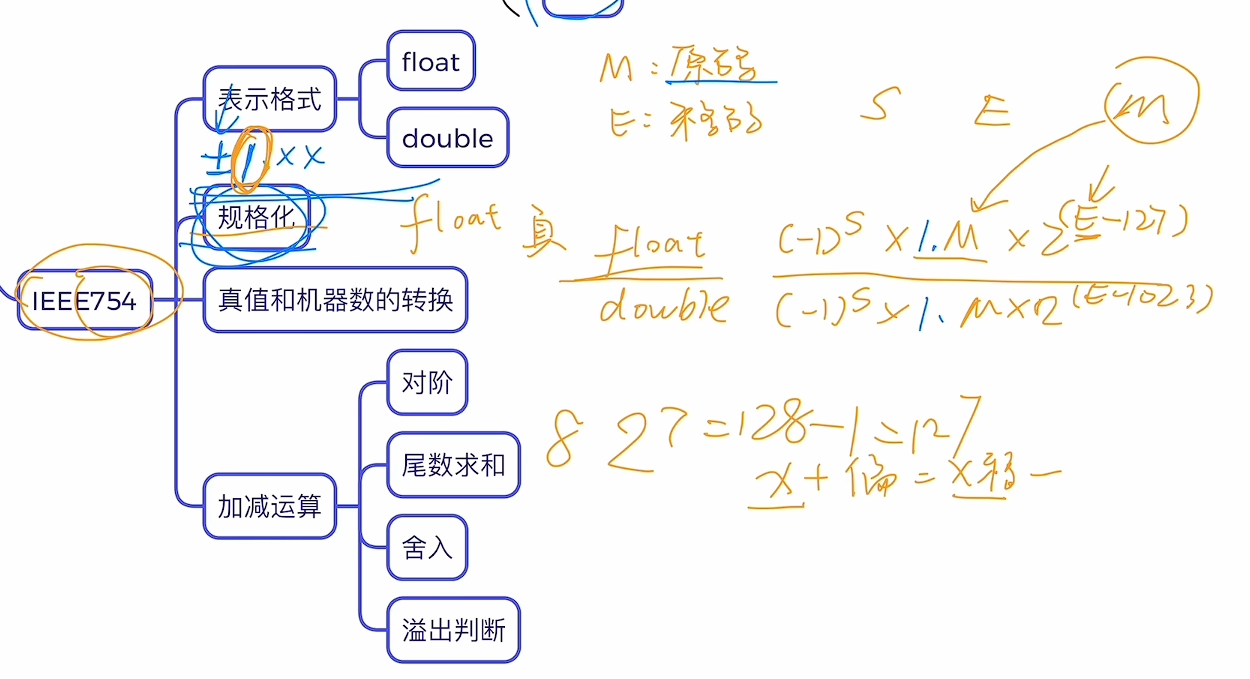
在IEEE 754中,偏置值不再是通常情况下的2^n-1^,而是在此基础上再减一,即2^n-1^ - 1。切记,IEEE 754会隐藏一个1。
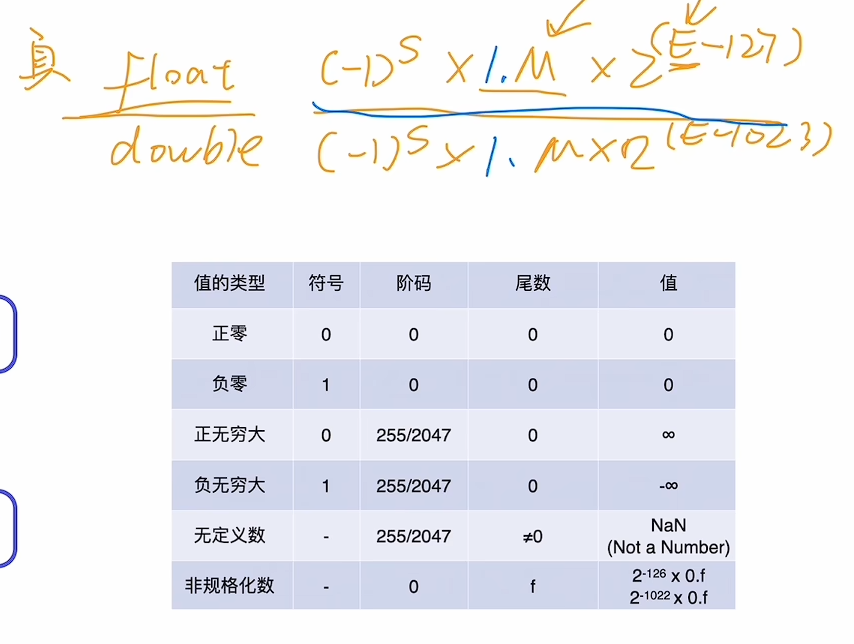
此处对非规格化进行补充:对于float而言
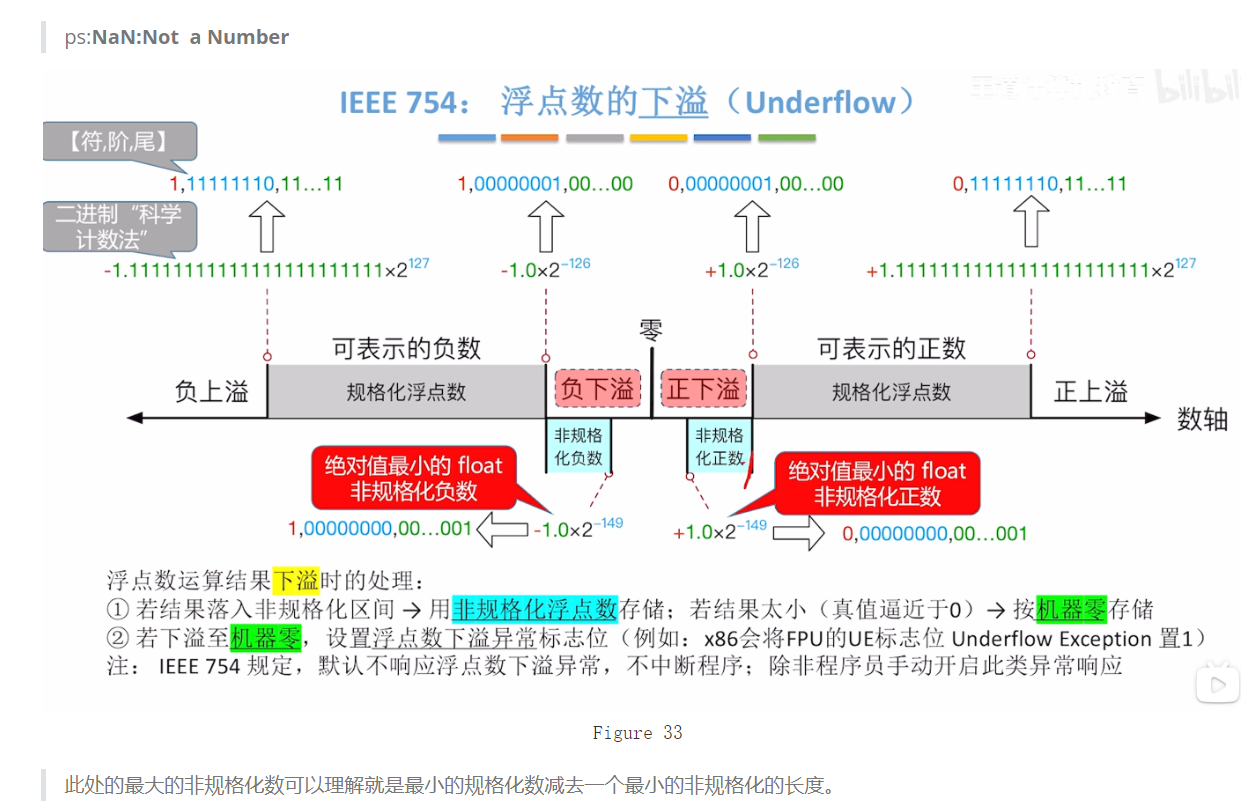
IEEE754中规定了非规格化的数隐藏位置为0。
加减运算
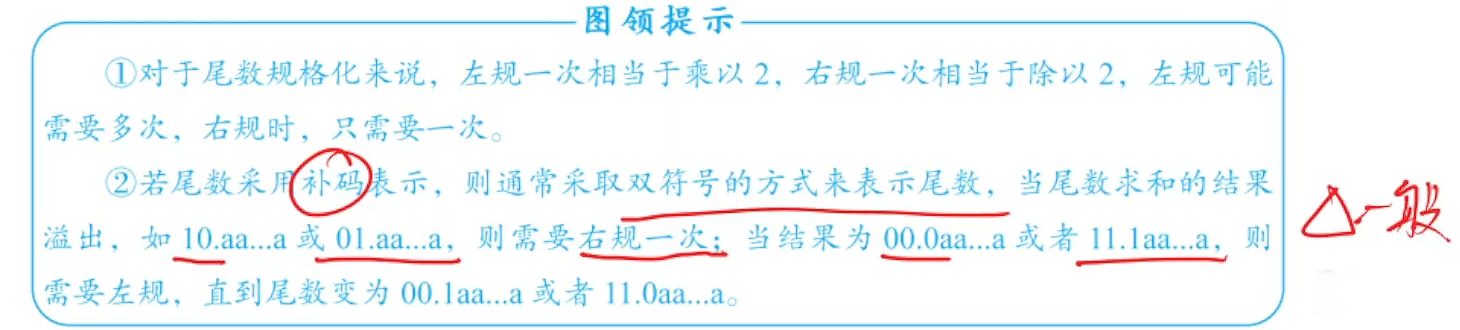
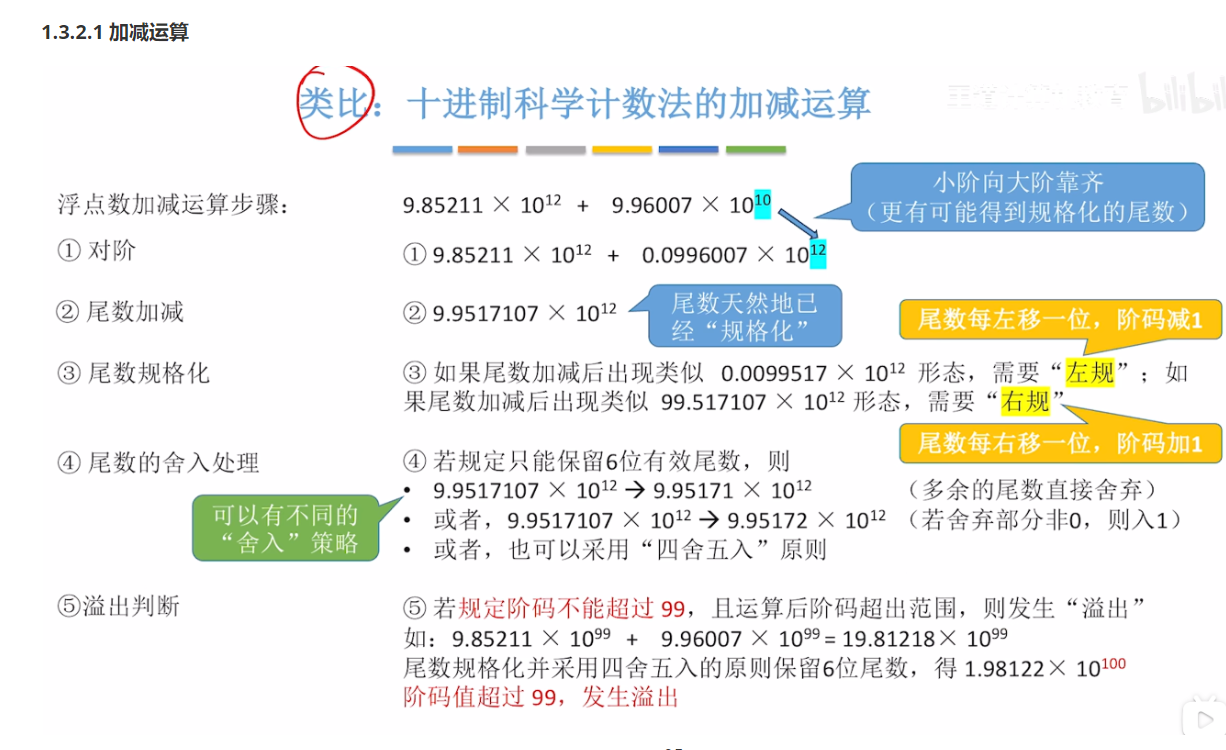
C语言强制类型转换
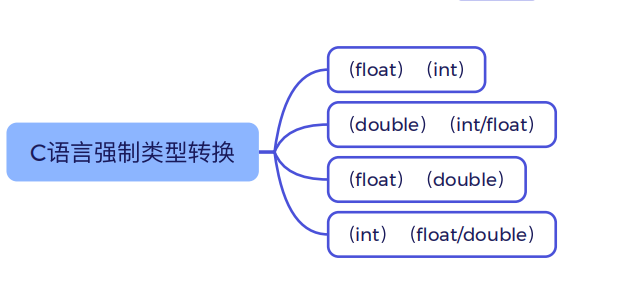
- int和float都是32位,但是float表示范围比int大,并且float能表示小数。但是float尾数部分只有23位,若加上隐藏位也只有24位,假如int的有效位数超过了24位就有可能造成精度的丢失。
- !!!在C语言中,数据进行类型转换时,先根据原先数据类型进行符号扩展或者0扩展,然后再进行数值的解读!!!
补充
乘除法简单理解
乘法运算实际上可以通过多次的加减运算和移位来实现。移位通常用来实现错位。
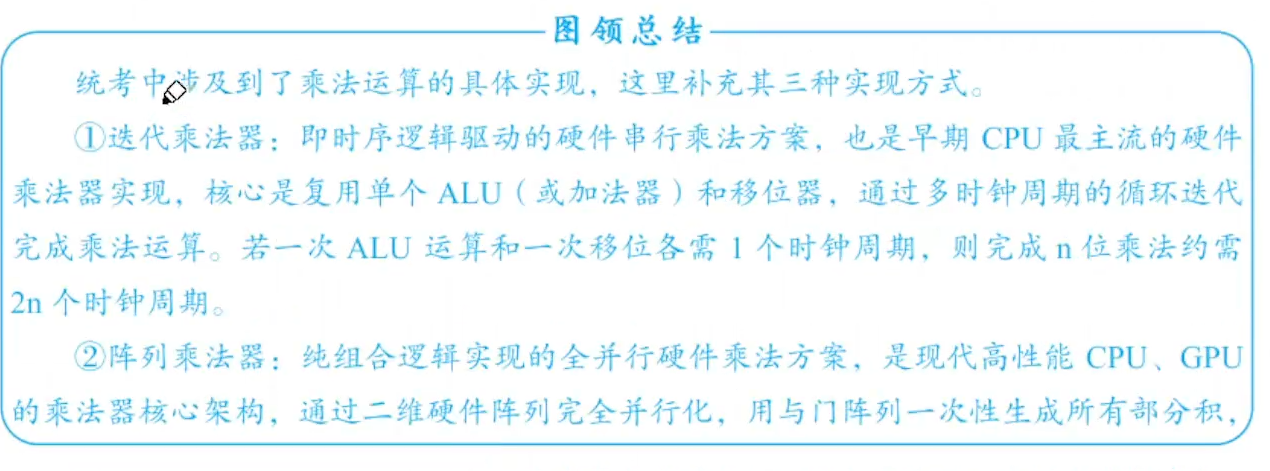
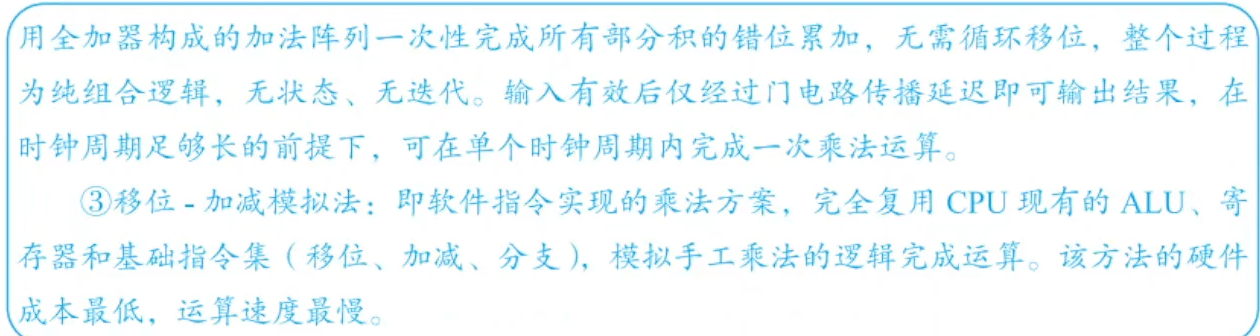
对于无符号整数的乘法是否溢出:若丢弃的高n位不全为0,则发生溢出,并置OF = 1
对于有符号整数的乘法是否溢出:若2n位的高n + 1位不完全相同,说明发生溢出,并置OF = 1
舍入
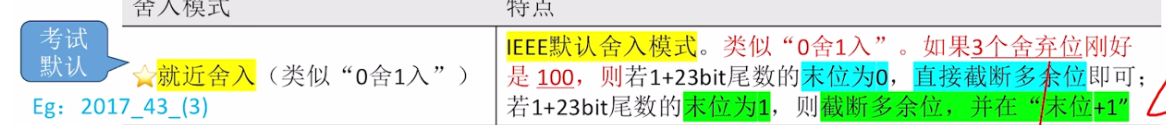
第一步先看多出来的数第一位是否是1,够不够0.5。
- 不够直接丢
- 够了再检查后面是否有1
- 有1( > 0.5)直接加1
- 没有1( == 0.5)要让保留下的尾数最低位是偶数
小端方式
以按字节存储为例
存储时先存储低字节,但是字节内不会先存储低位。比特顺序(Bit Order)不可见:因为内存的最小可寻址单元是字节(8 bits),所以 CPU 的访存指令只能精确计算和定位到字节,无法在软件层面单独寻址或存储一个字节内的某个比特。
按字节对齐、按边界对齐
-
按边界对齐 (Boundary Alignment)
-
存储机制:规定不同类型的数据必须存储在特定地址的边界上。通常,变量的起始地址必须是其数据类型大小的整数倍(例如,4 字节的
int其起始地址必须能被 4 整除,如0x00,0x04,0x08)。为了满足这一要求,编译器会在数据之间自动插入无意义的填充字节(Padding)。 -
硬件优势(用空间换时间):CPU 并非每次从内存中抠出一个字节,而是通过固定宽度的数据总线(如 32 位或 64 位)一次性读取一个“字(Word)”。如果数据按边界对齐,CPU 只需一次访存周期就能取到完整数据,执行效率最高。
-
代价:填充字节造成了内存内部碎片,使得结构体或对象的整体体积变大。这也是主流编译器(如 GCC、MSVC)的默认行为。
-
按字节对齐 (Byte Alignment / Packed)
-
存储机制:在对比语境下,它通常被称为“1 字节对齐”或“紧凑模式”(如 C 语言中的
#pragma pack(1))。这意味着所有数据一个挨着一个紧密排列,起始地址可以是任意字节,完全无视边界规则。 -
空间优势(用时间换空间):内存利用率达到 100%,没有任何浪费。常见于对体积要求极其苛刻的场景,例如网络传输协议的报文头、或是极小容量的固件存储中。
-
代价:致命的性能损耗。假设一个 4 字节的
int被存放在了奇数地址(例如0x01到0x04),它将横跨两个内存总线读取边界(0x00-0x03和0x04-0x07)。此时 CPU 必须执行两次独立的内存读取,将两部分数据放入寄存器,再通过移位、掩码和拼接指令才能拼凑出原始数据。在某些架构(如部分 ARM 或 MIPS)上,这种非对齐访问甚至会触发硬件异常(Bus Error),直接导致程序崩溃。 -
结构体
-
在计算机(以及 408 考试标准中),决定结构体起始地址对齐要求的,不是全部成员加起来的总和,而是结构体内部“最宽的基本数据类型成员”的大小。但是如果是结构体内部成员的地址就得是自身所占存储单元数量的整数倍,这在编译器中被称为成员对齐规则(Member Alignment)。
-
结构体遇到数组成员,把数组“打散”看。计算对齐系数时,只看数组内部那个最基本的元素类型是多大,跟数组里面有多少个元素毫无关系。
乘法具体实现
无符号数
除法具体实现
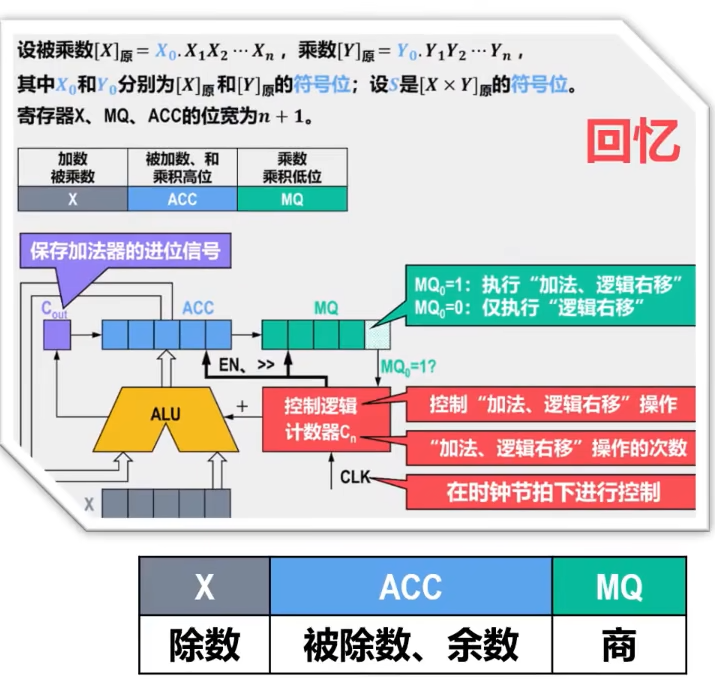
- 除法也是靠补码加法、减法和移位实现的。
- 除法有两种可能会发生溢出:除零异常 :最基础的数学铁律,分母不能为0。补码溢出异常:这是补码非对称性带来的特有陷阱。32 位带符号补码能表示的最小负数是 \(-2^{31}\)(机器数为
8000 0000H),而最大正数是 \(2^{31}-1\)。当使用最小负数除以 -1(机器数为FFFF FFFFH)时,真实结果应为 \(+2^{31}\),这超出了 32 位正数的表示上限,从而引发正数上溢。
原码表示
分为恢复余数法和不恢复余数法