存储系统
主存
结构
位数关系
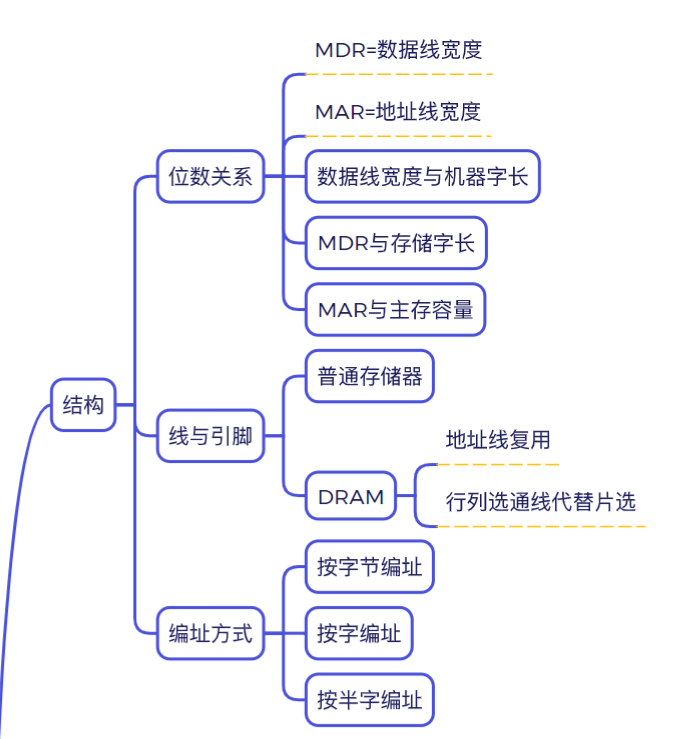
- MDR位数和数据线的宽度有关,和存储字长不一定相等。
- 若按字(机器字长)编址(即按字边界对齐),逻辑上相当于把好几个字节分到同一个存储单元内了。这时地址会变少,但是MAR位数不会变,PC可以变。例如,PC只传高位,MAR补足低位。
线与引脚
- 引脚的数量和存储器容量无关,和芯片有关。
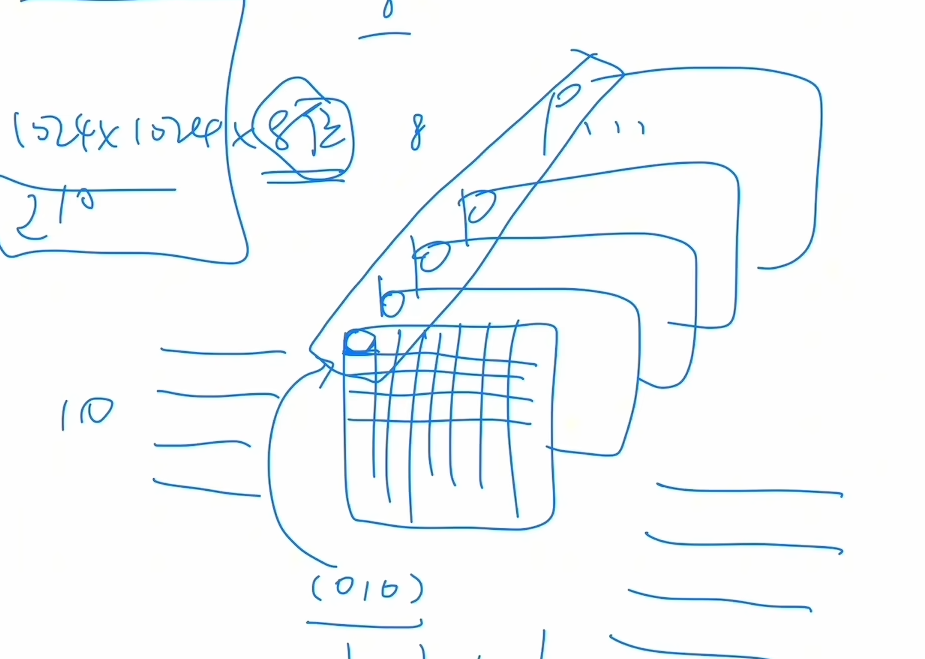
- 例如:1M X 8位指的是1M个存储单元,每个存储单元存储字长为8位。注意,每个存储单元都需要一个地址,因此一共1M个地址,需要20位表示,也就是20个地址引脚。
- 多个芯片进行扩展时,如下图这样算是一个存储单元。
扩展
字扩展
-
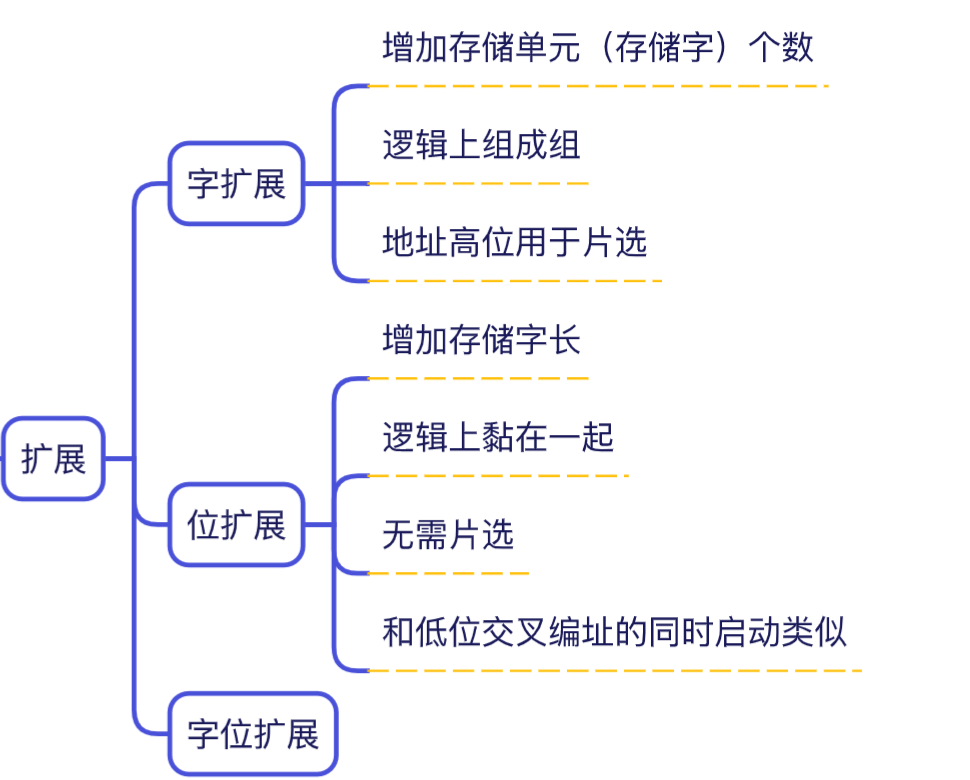
因为字扩展增加了存储单元的个数,因此在访问一个每个芯片都有的存储单元时就不知道要访问哪个,因此就利用CPU高位多余的线(可能用了后,高位还有多余的线没用),产生了片选,就是选哪个芯片。
-
片选时有两中方法,第一种是译码法,也是最常用的,也就是2^n^;第二种是线选法,也就是一根片选线对应一个芯片。
- 字扩展不同芯片的数据线是可以连到同一根线上的,因为需要片选就不可能同时发送数据。
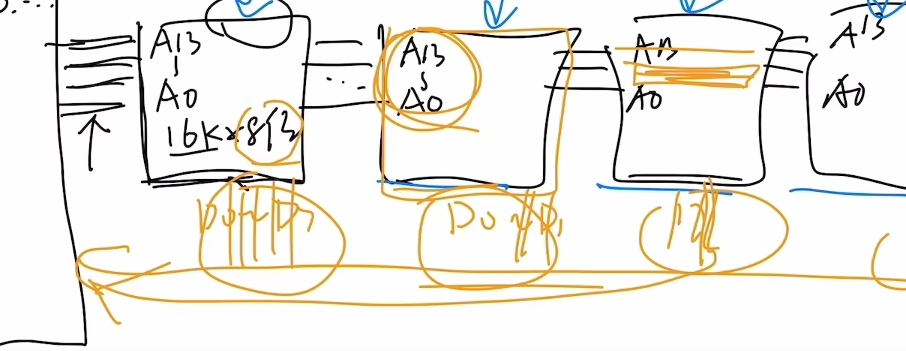
- 上述提到DRAM的行列选通线可以代替片选线(RAS、CAS),结合下图理解:
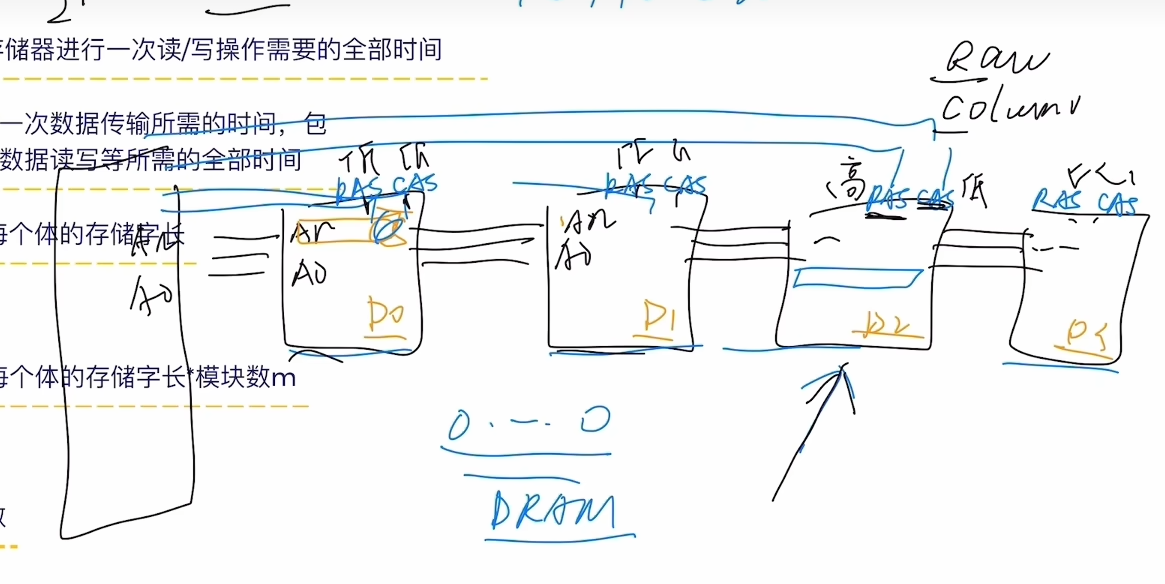
上图的电平只是用来演示,现实情况可能并非如此。假设此时第三个芯片要进行行地址的发送,规定RAS高电平代表行地址是标准形式,其他都是低电平,就可以知道只有第三个芯片是标准的,因此实现了片选的功能。
位扩展
- 位扩展没有片选一说,因为时扩展了存储字长,每个芯片都是必须的。
- 位扩展的数据线是不能像上面一样可以连到同一根线上的,因为不存在片选,需要同时传。
无论字扩展、位扩展地址线都是连一块的,只是有无片选的区别。
存储周期与总线周期(结合1.6)
忽略下图同时启动的r = T
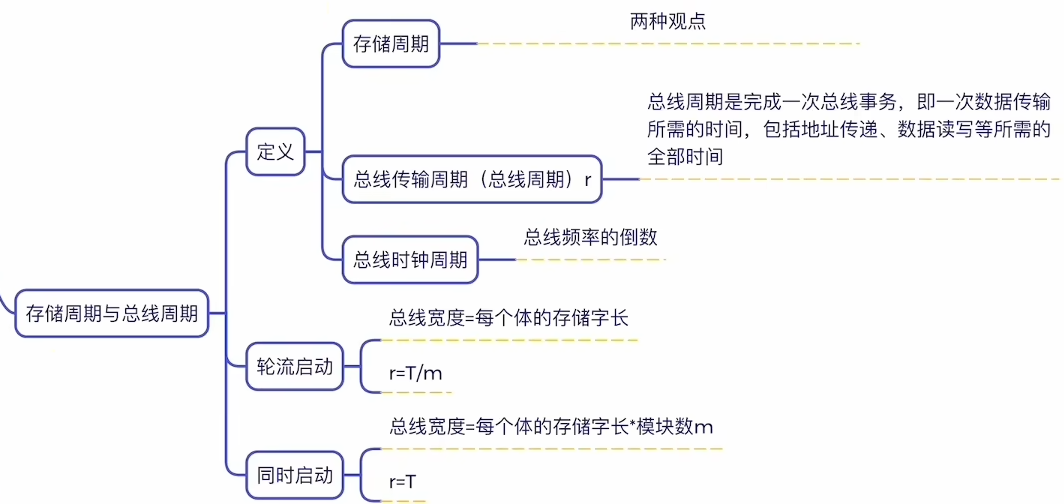
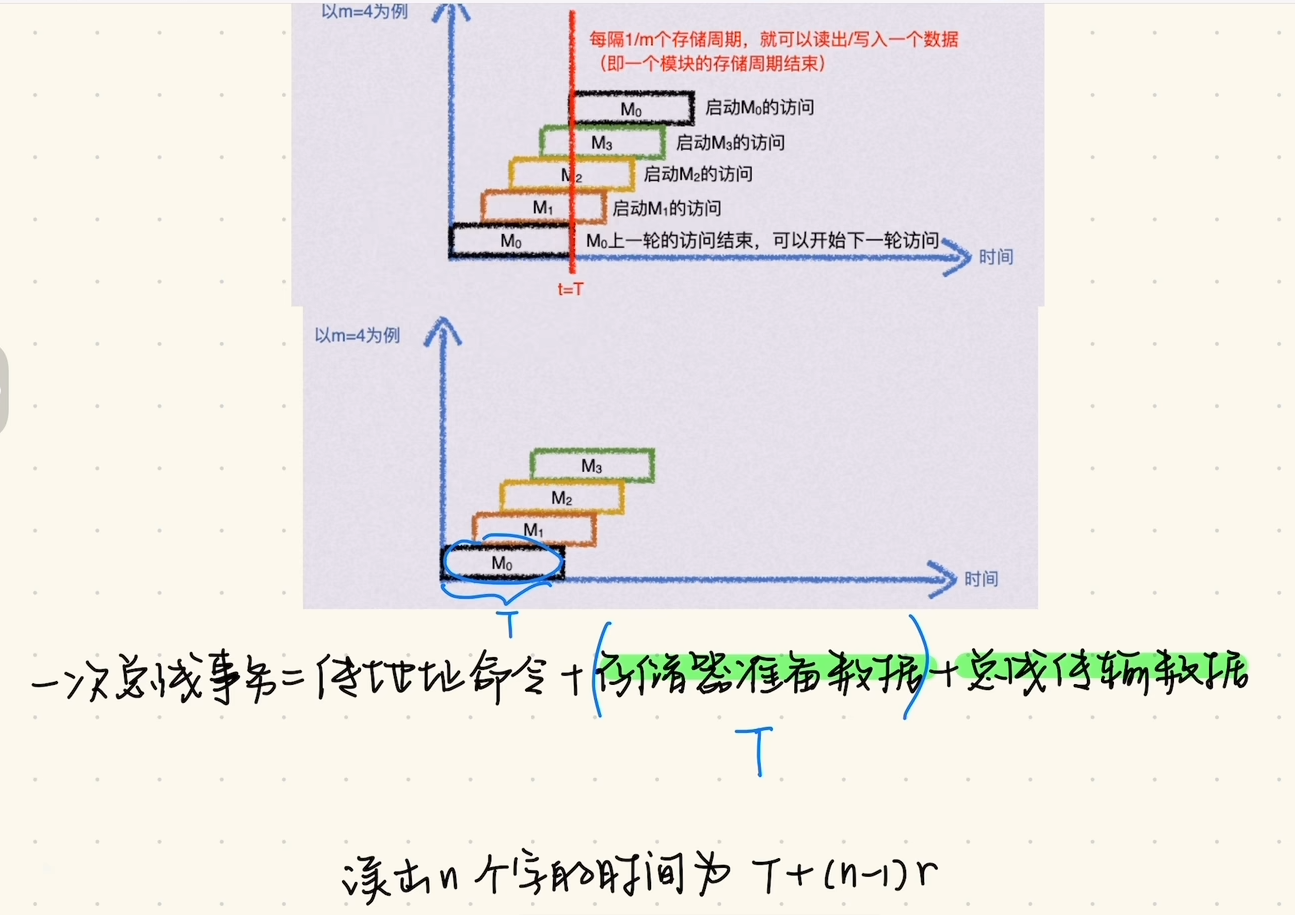
此处的r其实是总线传输一次数据所需要的时间,但是通常,我们会设置r = T / m
- 通常情况下,**1个总线传输周期 == n*总线时钟周期 **
边界对齐
- K字节的数据起始地址必须是K的倍数
大端和小端
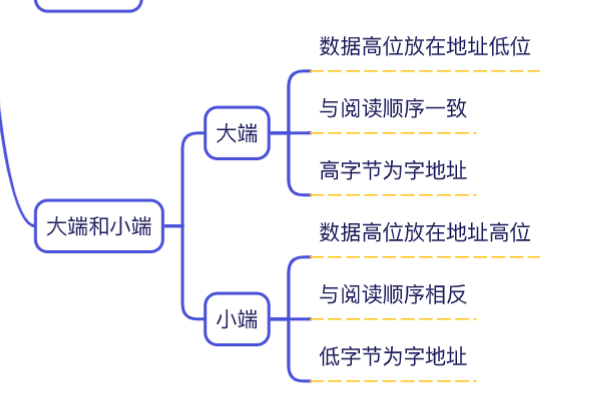
- 字地址是首地址,高字节指的是数据的高位,低字节同理。
主存系统的优化
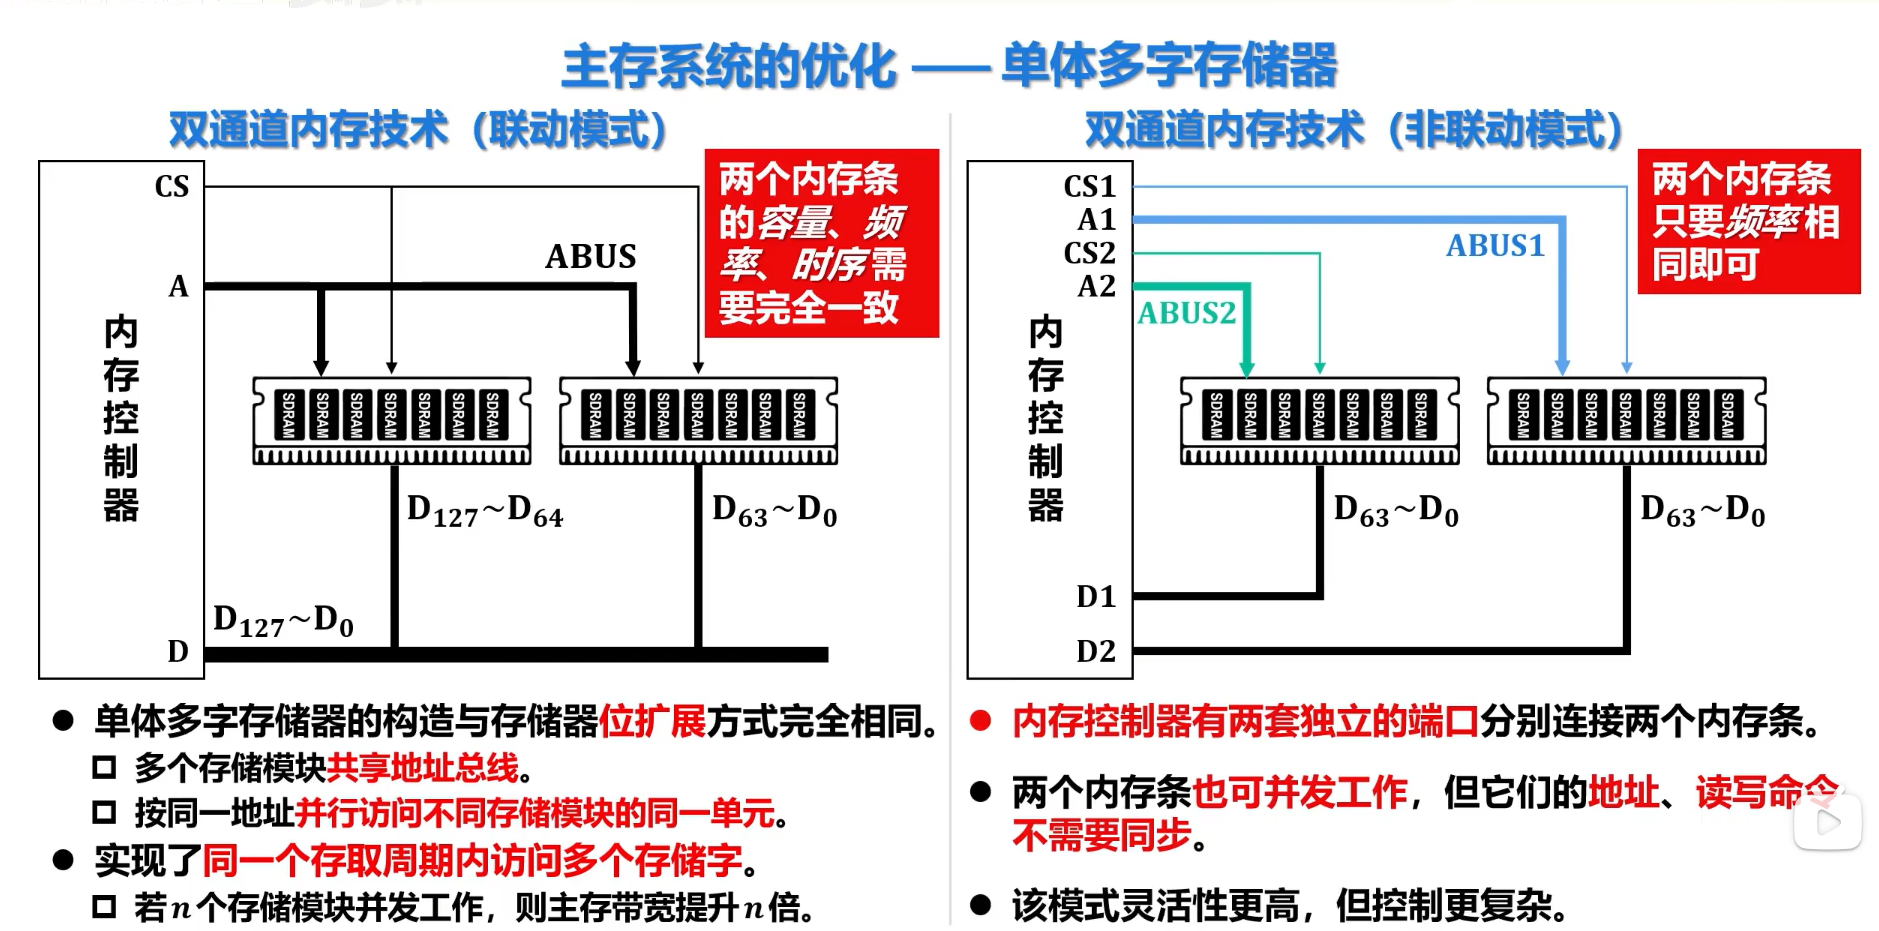
单体多字存储器
多体交叉存储器
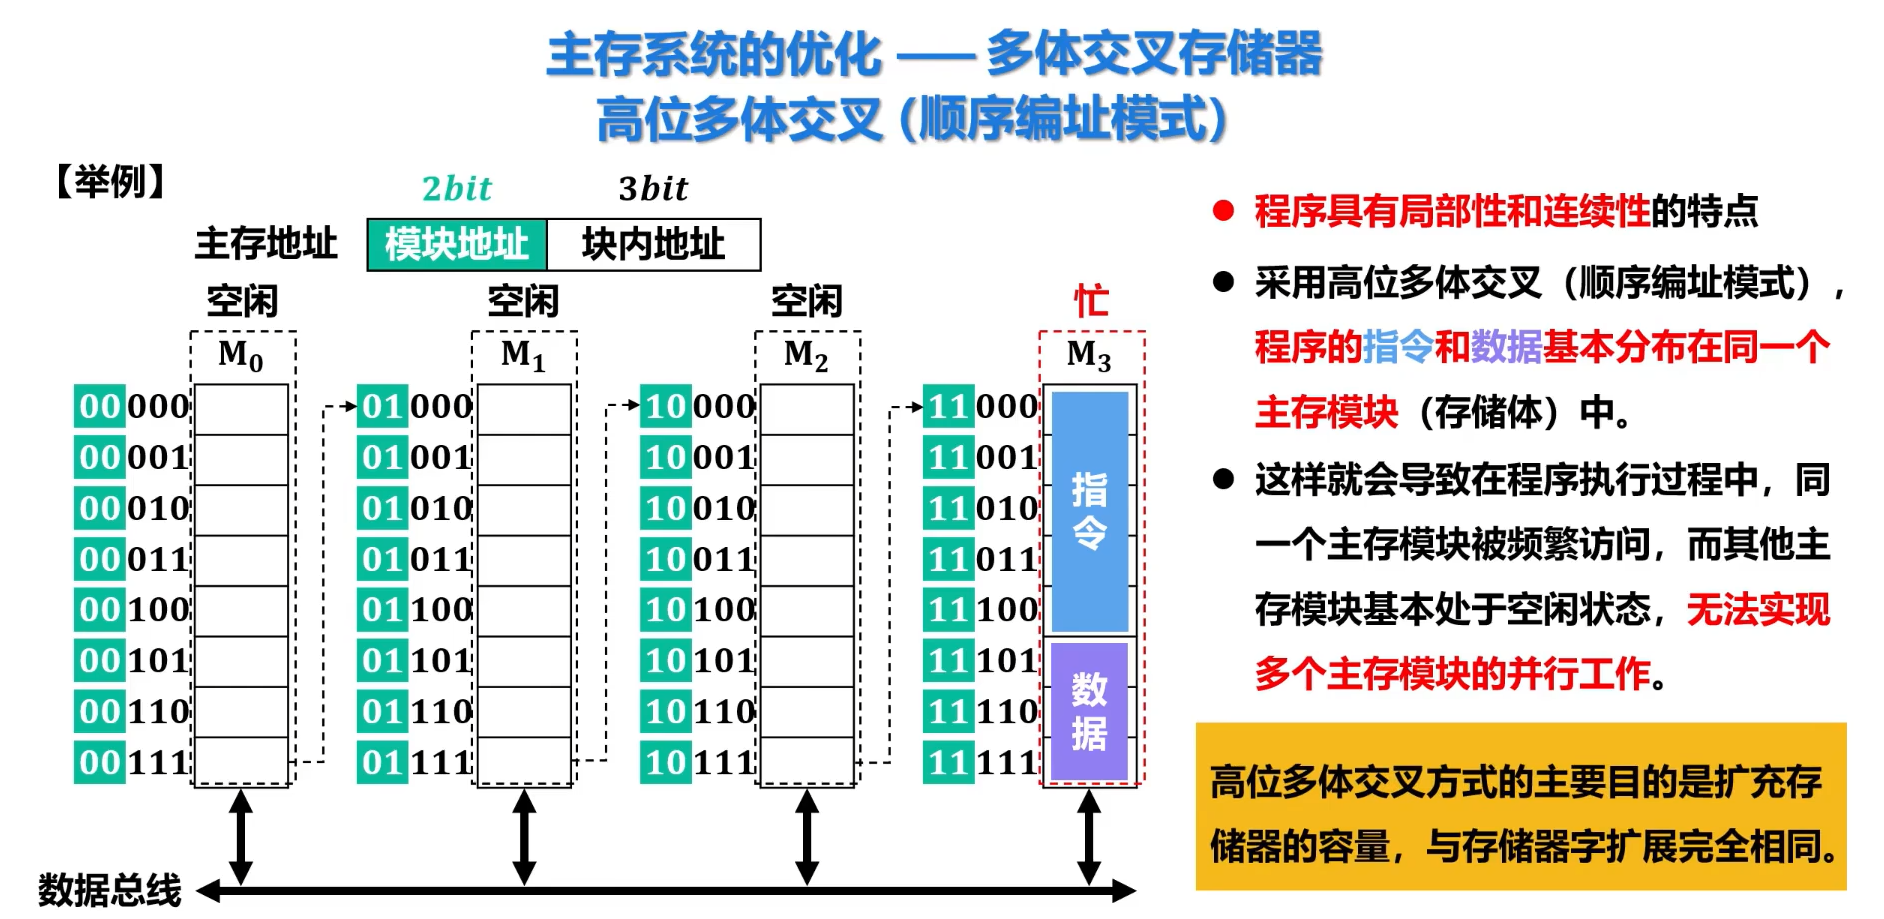
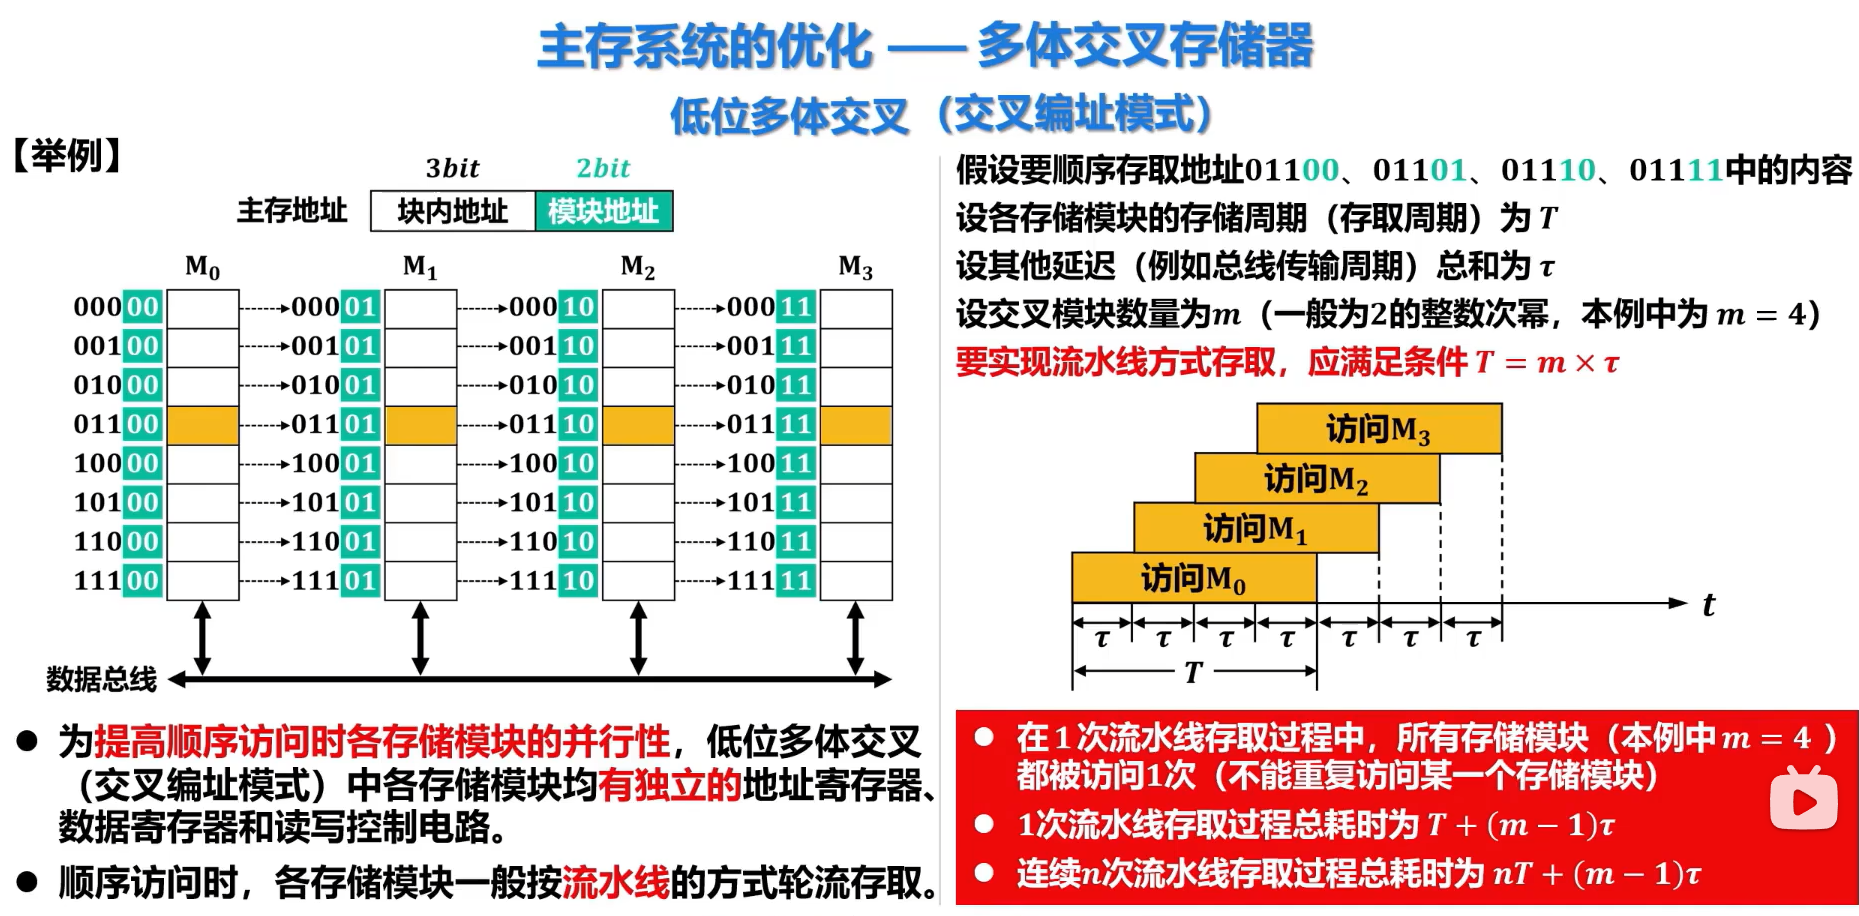
高位低位指的是对多个模块编址方式的不同。
高位多体
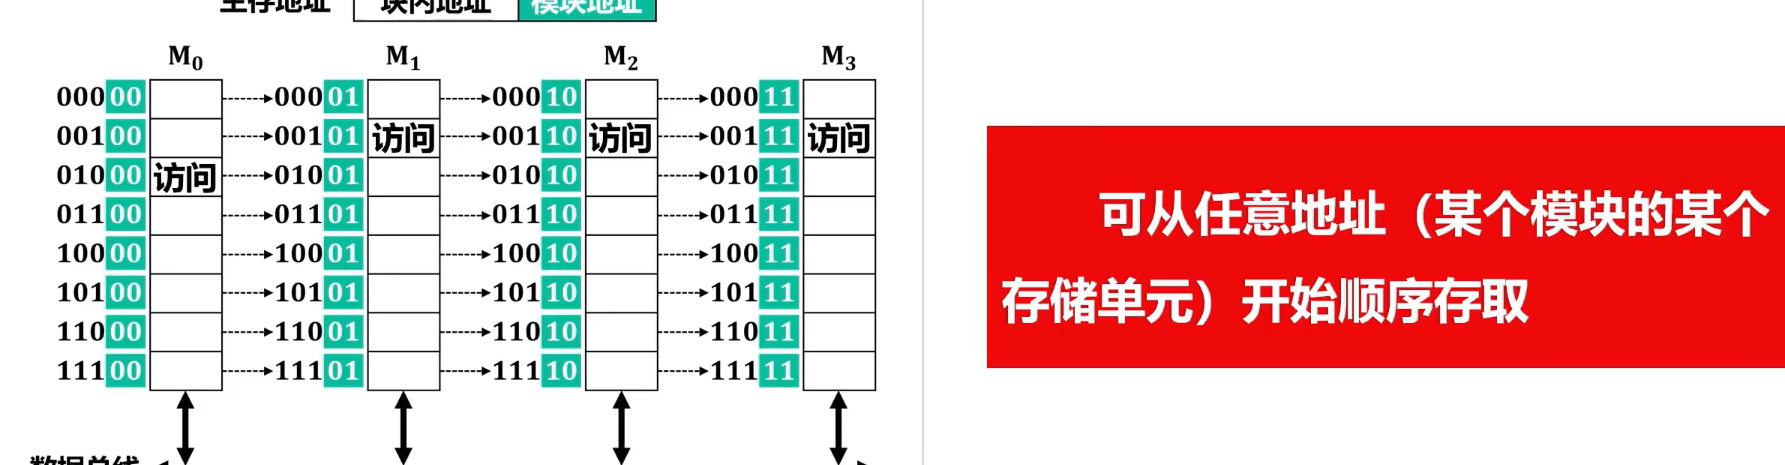
低位多体
Cache
地址结构
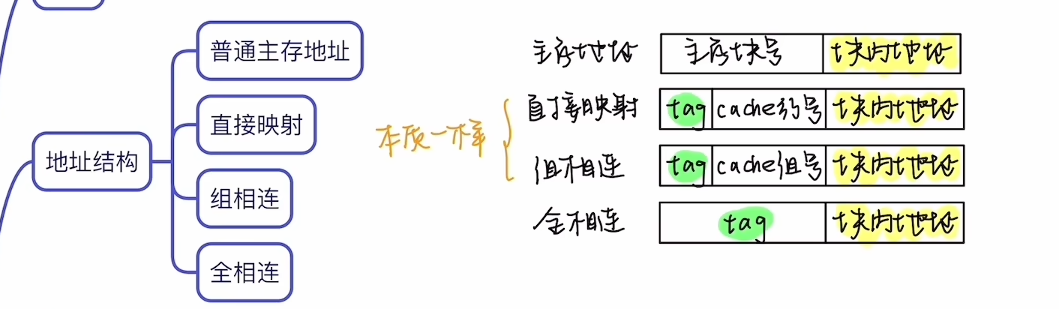
- 组相联,组间相当于直接映射;组内相当于全相联映射。几路组相联,代表的是一组内有多少个cache行。
- 直接映射相当于一路组相联。
- 全相联相当于(cache行数)路组相联。
- 直接映射的tag位还可以这么求:假设主存快数量是Cache行数量的4096倍,那么就代表这4096个主存块要去争抢一个Cache行,因此需要12位的tag位来标记是谁正在使用。
cache行的内容
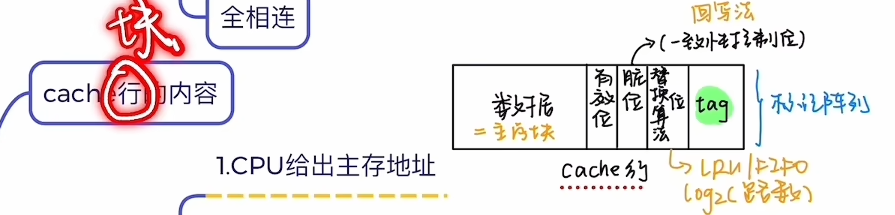
- 一行内虽然有多个存储单元,也就代表着有多个tag,但是一个cache行中只会存一个tag,这是因为这些数据都是同一块内的,他们的高位一定是相同的,因此我们只取相同部分为tag。
- 有效位和tag位是一定存在的。
- 脏位也称为一致性控制位,只在回写法时才有,就是看它是否修改过。
- 可以从上图发现,Cache行中的有效位并不在Tag中!TLB也是如此!
访存过程
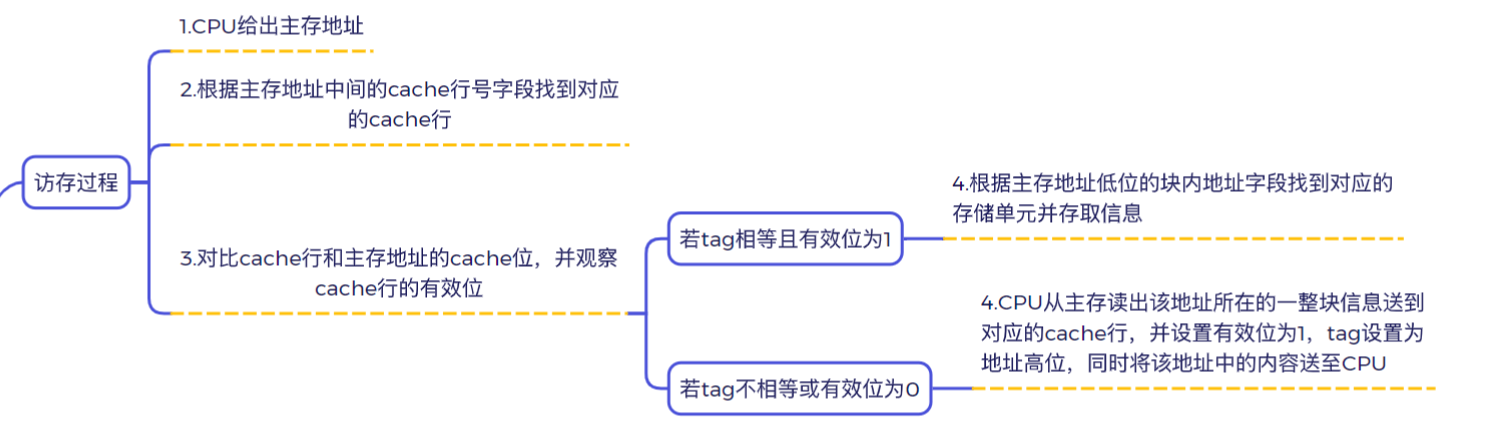
写策略
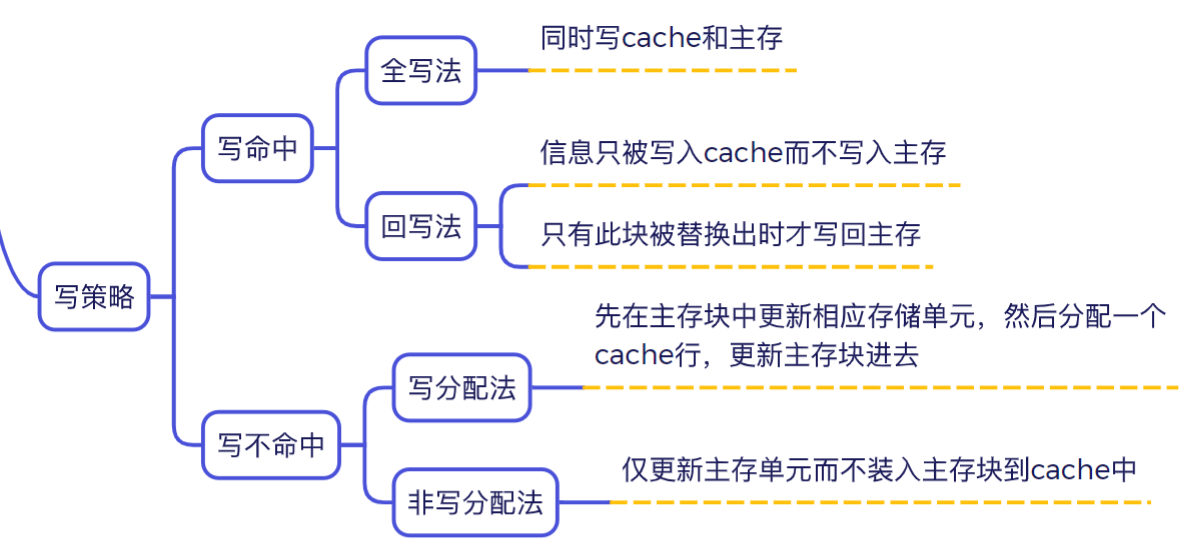
- 回写法和写分配法通常是搭配一起用的
- 对于任何常规的 Cache 系统,只要发生“读缺失”,处理的通用逻辑永远是: 去主存里把包含目标数据的整个主存块读取出来,把 CPU 需要的那个字发送给 CPU,同时将这个完整的块复制一份存入 Cache 中。
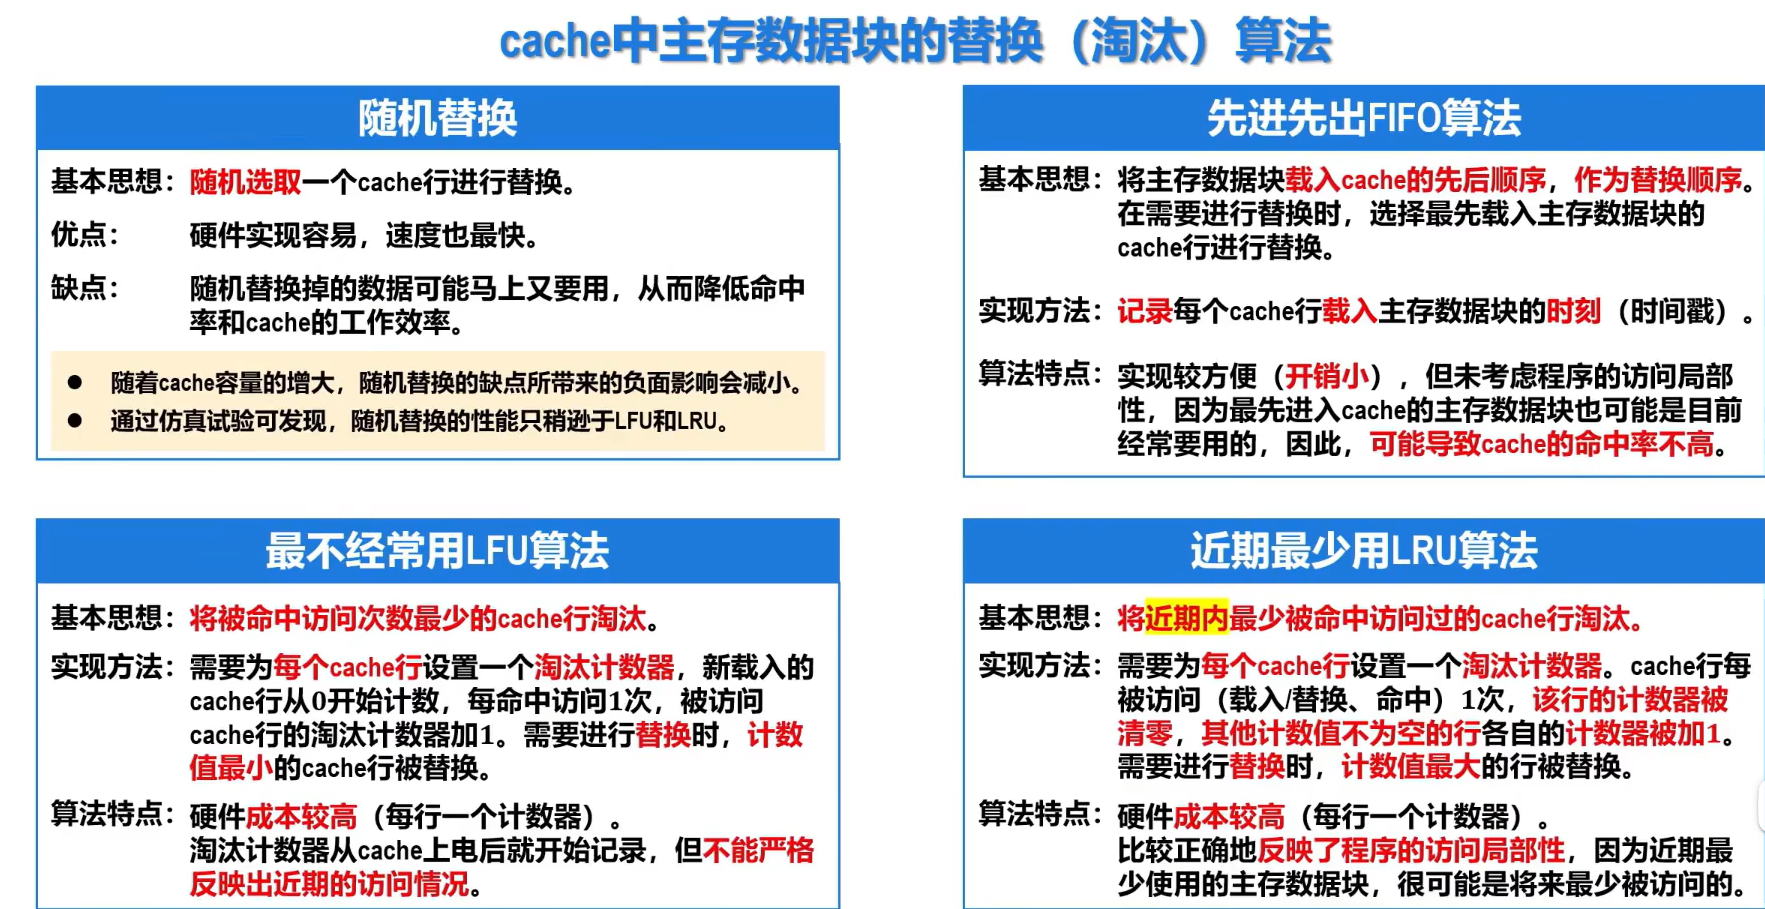
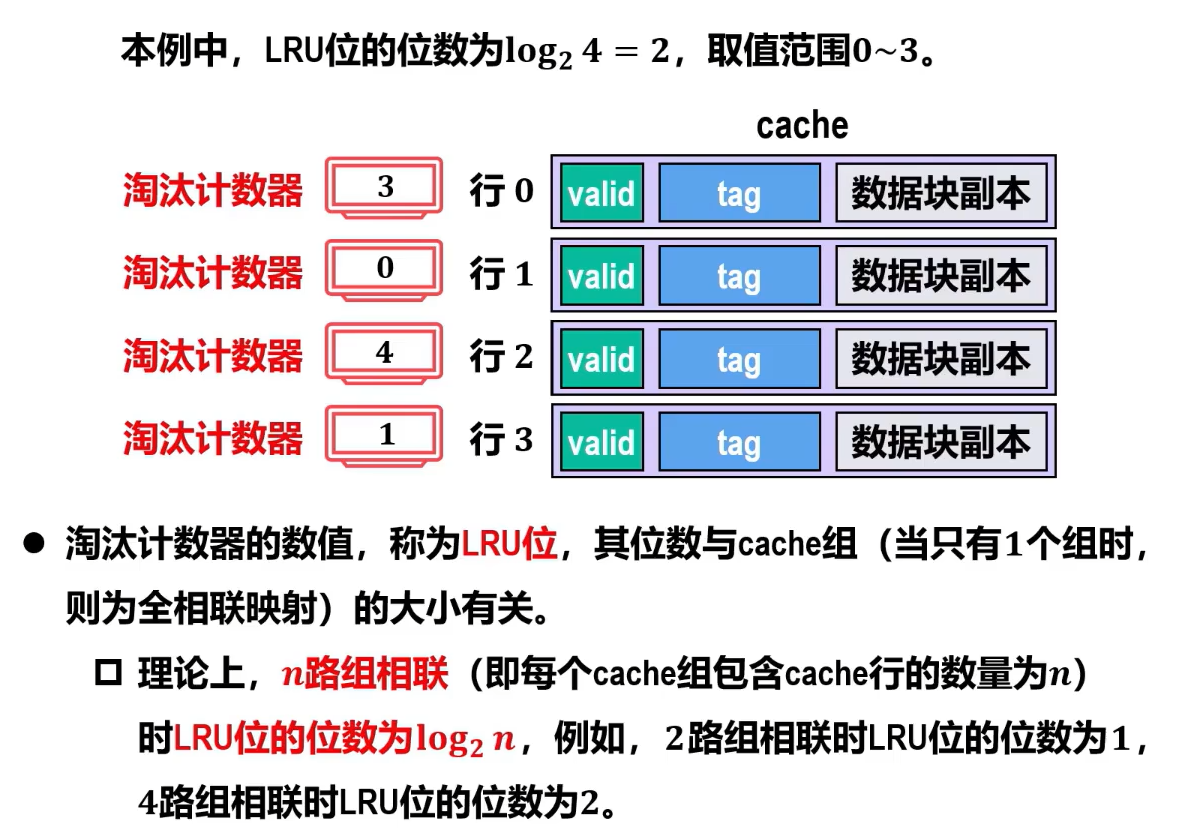
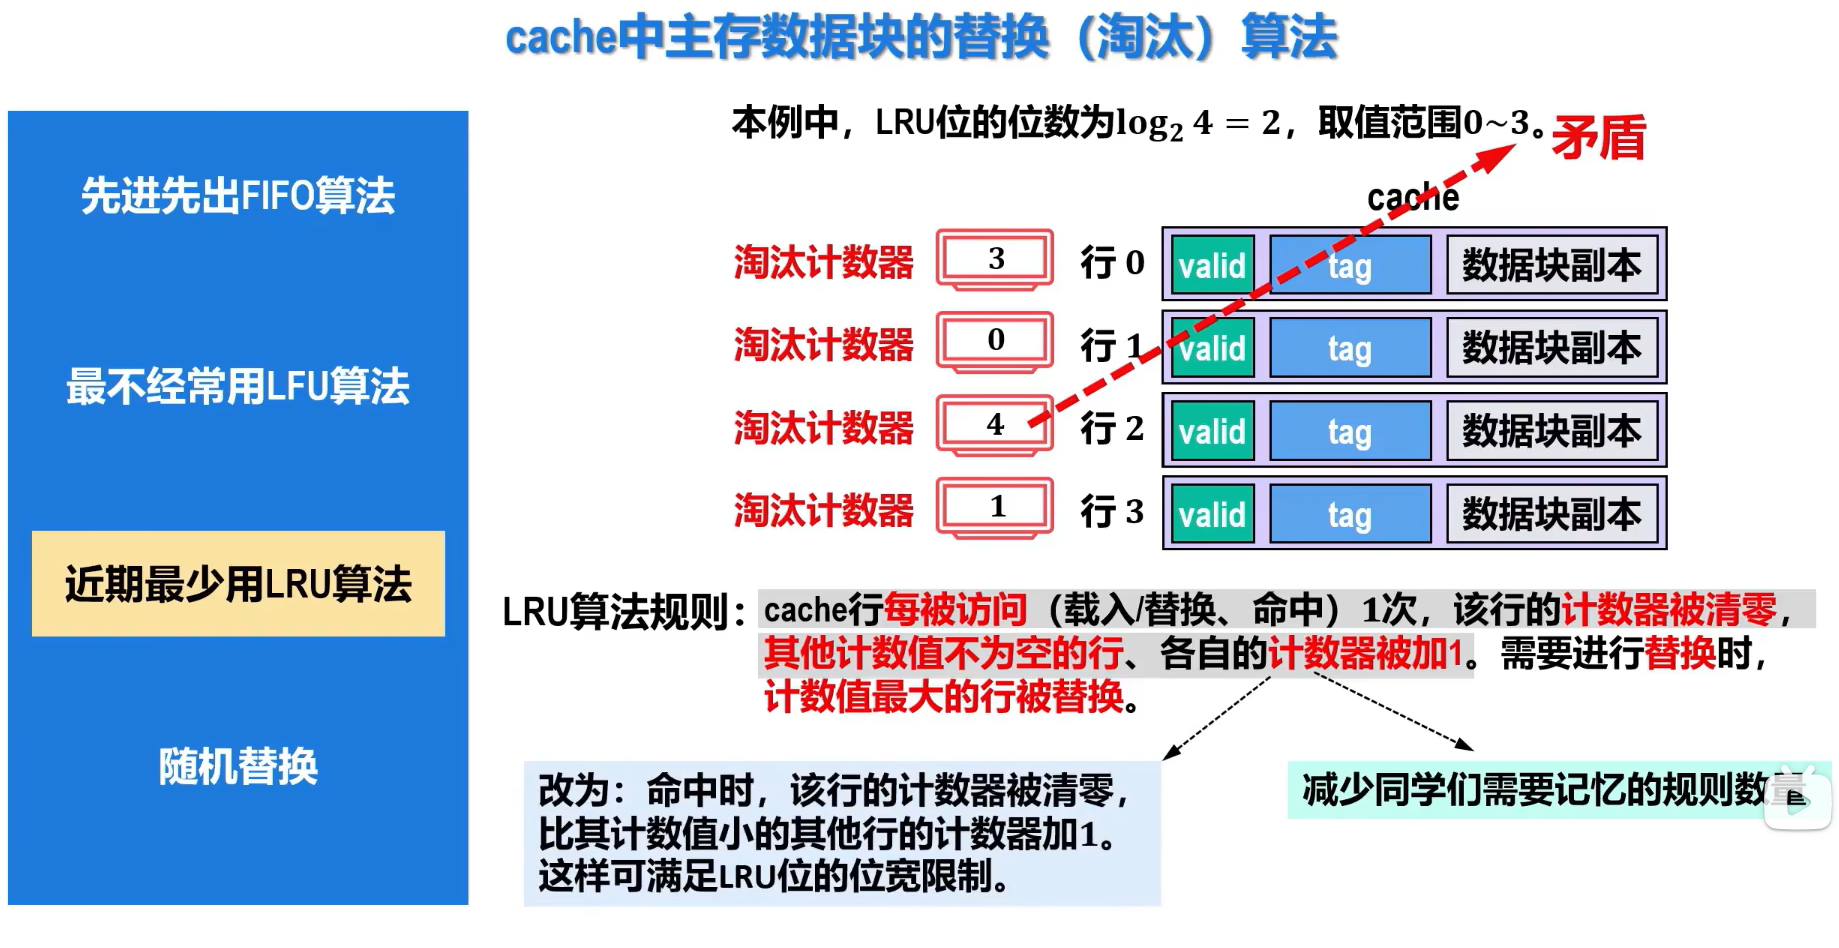
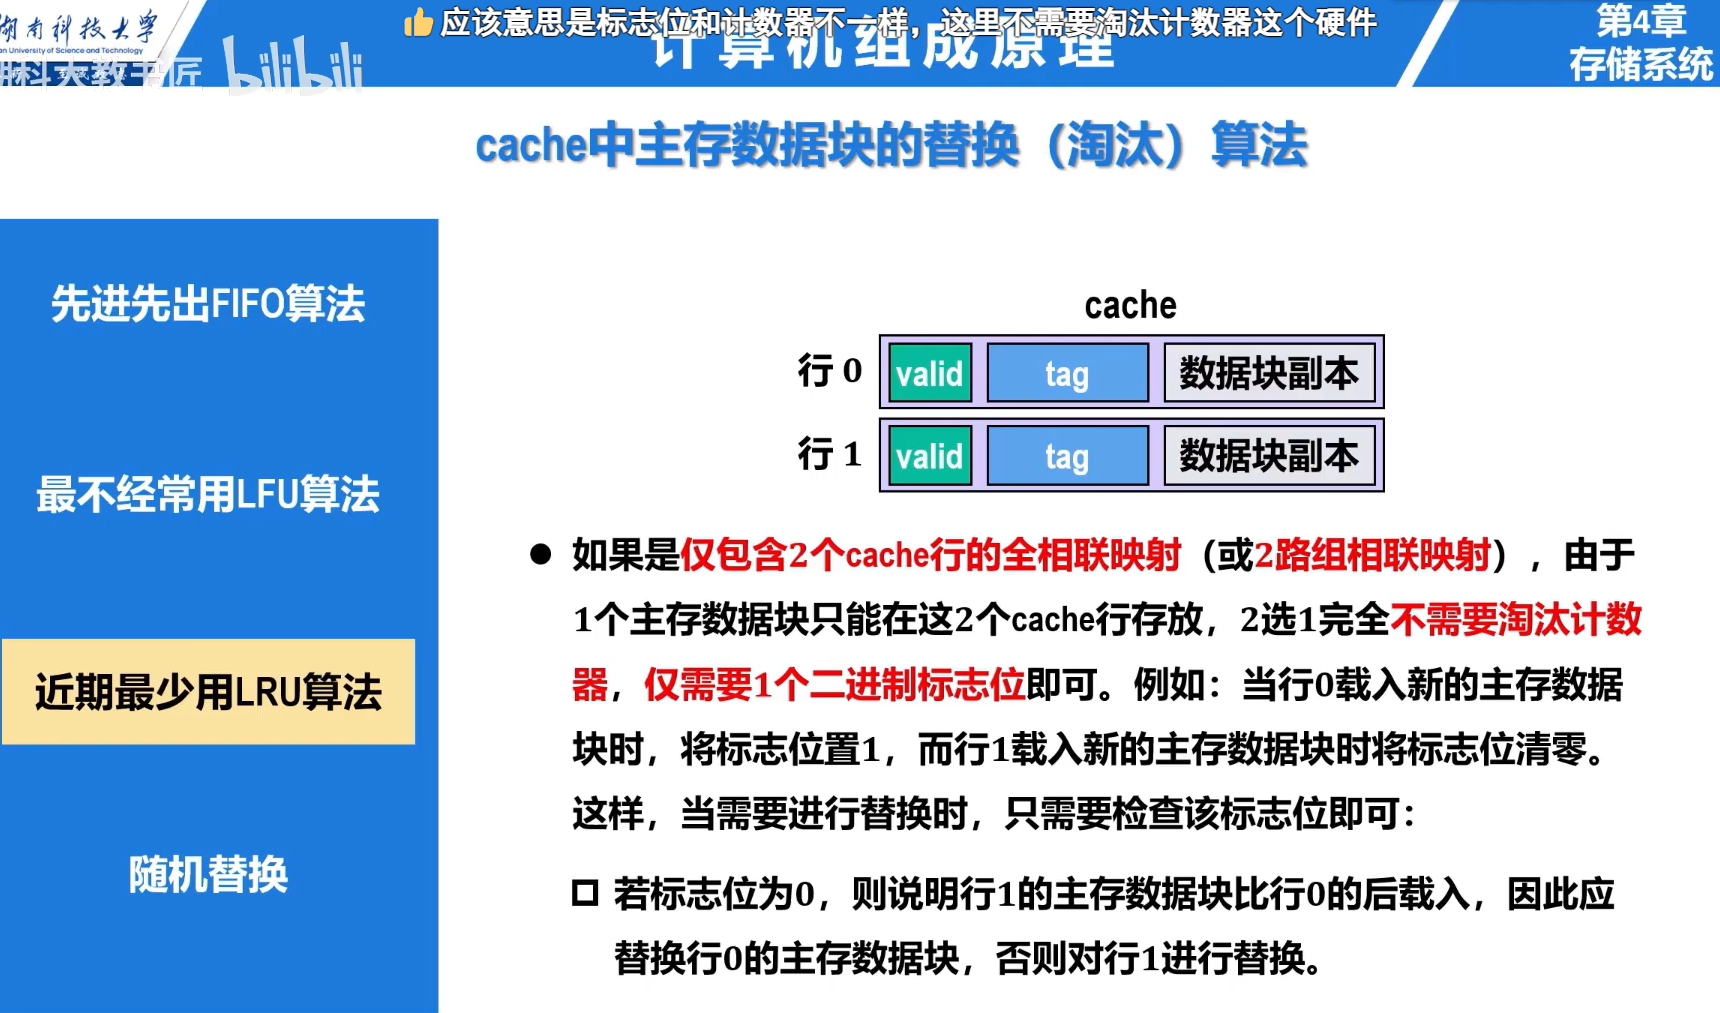
替换算法
虚拟存储
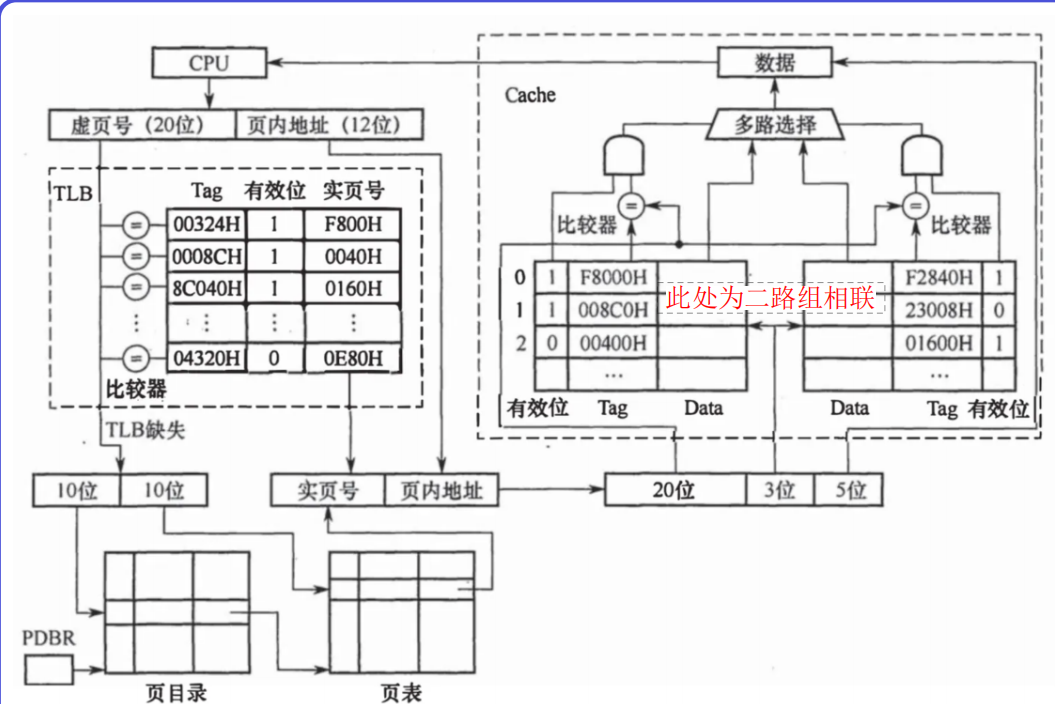
页目录是多级页表中最顶级的那张页表
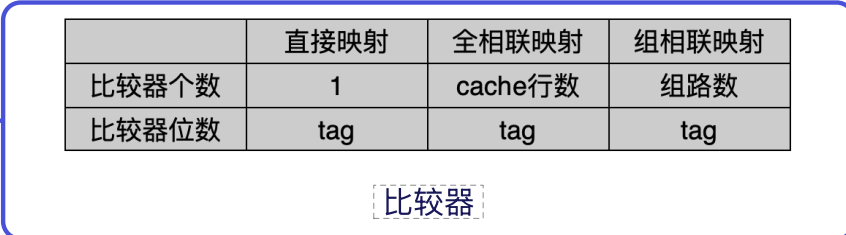
总结一下,比较器就是用来快速去检查 tag 位以及有效位的。同时,在 N 路组相联中,会设置 N 个比较器来对一组内的 N 行进行同时比较,方便快速找出所在行号。
-
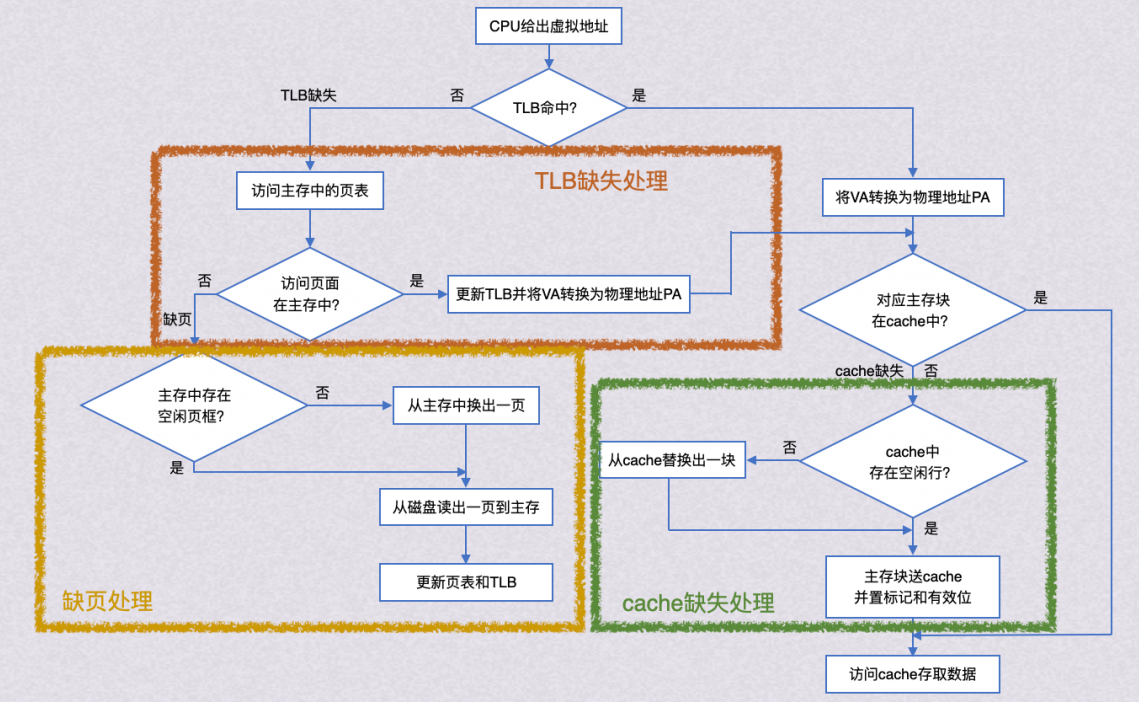
缺页是异常,会引发内中断;但是Cache缺失不是异常。
-
快表通常集成在 CPU 内部,而不在主存中。
- 快表命中了,page一定命中。
- TLB和Cache都由SRAM
- 主存和外存之间通常采用回写法。
- 由于访问外存的代价很高,因此提高命中率是关键,所以主存和外存之间通常采用全相联映射。
磁盘
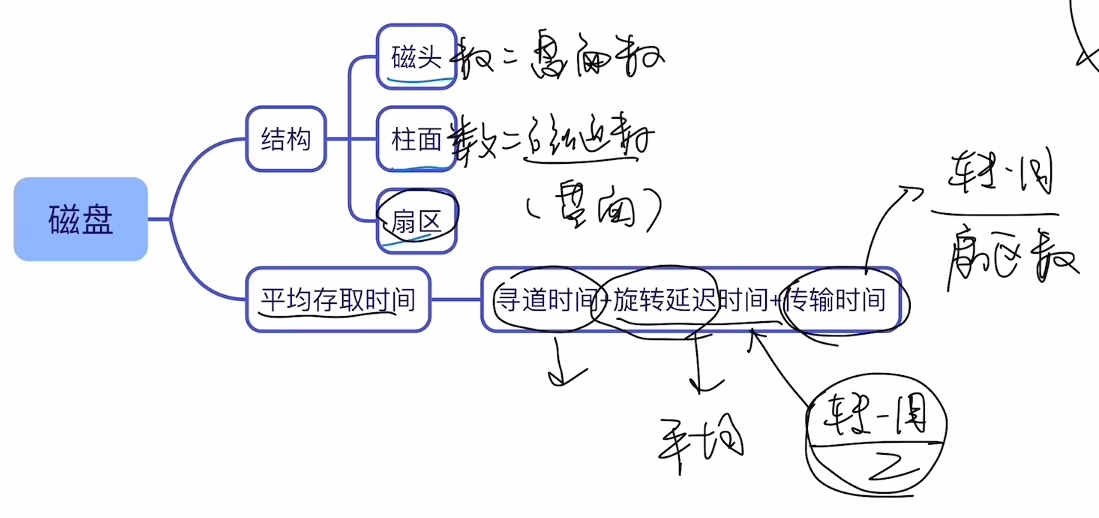
Cache计算中的一些问题
Cache速算
先根据题目给出的条件划分出主存地址格式,然后要取哪部分就进行右移 + 模的操作,然后对应到十进制,进行除和取余的操作会简单很多,还不易出错。
例如:
【题目核心条件】
-
地址空间长度:28
-
Cache行大小:64B(决定块内地址为6位)
- Cache总行数:8行(决定Cache行号为3位)
- 数据结构:
int a[256][256],按行优先存放 - 起始地址:首地址为 320,每个
int元素占 4B - 映射方式:直接映射
- 编址方式:按字节编址
可得,主存地址格式为:
| Tag | Cache行号 | 块内地址 |
|---|---|---|
| 19位 | 3位 | 6位 |
计算 a[0][31] 映射的 Cache 行号:
a[0][31]地址 == 320 + (0 * 256 + 31) * 4 == 444
为了截取中间三位,先除2^6^(右移6位),再模2^3^保留剩下的最低三位即为所求:
444 / 64 == 6 -> 6 % 8 == 6
(结论:映射到第 6 行)
平均访存时间 (AMAT) 的计算与避坑
计算 Cache 的平均访存时间时,最容易犯的错误是重复计算命中时间。
- 标准公式:
\[AMAT = \text{命中时间} + \text{缺失率} \times \text{缺失代价}\]
-
物理意义理解:
-
命中时间 (Hit Time):是每次访存的“保底消费”。无论最终是否命中,CPU 都必须先查一遍 Cache。
-
缺失代价 (Miss Penalty):是发生缺失时才需要支付的“额外罚款”(例如去主存搬数据)。题目中给出的“缺失损失 200 个时钟周期”通常只指代这部分纯额外的开销。
-
避坑指南:绝对不要使用 \(\text{命中时间} + (\text{命中时间} + \text{缺失代价}) \times \text{缺失率}\) 这种公式,这会导致在缺失概率下,基础的命中时间被计算了两次。
-
AMAT推导:
-
\[AMAT = \text{命中率} \times \text{命中时的总花费} + \text{缺失率} \times \text{缺失时的总花费}\]
-
\[AMAT = \text{命中率} \times \text{命中时间} + \text{缺失率} \times (\text{命中时间} + \text{缺失代价})\]
- \[AMAT = (\text{命中率} + \text{缺失率}) \times \text{命中时间} + \text{缺失率} \times \text{缺失代价}\]
- \[AMAT = \text{命中时间} + \text{缺失率} \times \text{缺失代价}\]
Cache 块对齐与跨块缺失分析
当数组在内存中连续存放时,起始地址是否与 Cache 块大小对齐,直接决定了总的 Cache 缺失次数。
- 判断是否对齐的方法:
查看数组首地址的低位偏移量。以题中主存块大小为 64B 为例,64B 对应地址的低 6 位。若首地址的低 6 位不全为 0,则说明未按 Cache 块边界对齐。
题目实例:
d[0]虚拟地址为0180 0020H,低 6 位为20H(十进制 32),说明偏移量为 32B,未对齐。
- 未对齐导致的“碎片化”影响:
每个 Cache 块原本可装入 16 个 int 元素(64B / 4B)。
- 首块残缺:由于偏移了 32B,第 1 个 Cache 块只能装下后半部分的 32B,即只能容纳 8 个元素(
d[0]~d[7])。 -
尾块增加:数组剩余 \(2048 - 8 = 2040\) 个元素。\(2040 \div 16 = 127\) 余 8。这意味着中间有 127 个满载的块,最后还有 8 个元素需要独占 1 个块。
-
结论:如果完美对齐,只需要 \(2048 / 16 = 128\) 次缺失;但由于起始地址偏移,导致头尾两端各产生了一个未装满的块,总缺失次数变为 \(1 + 127 + 1 = 129\) 次。
虚拟地址直接映射 Cache 索引
在采用页式虚拟存储管理的系统中,有时可以直接用虚拟地址的部分位作为 Cache 的索引(组号),从而加速查找。这取决于页大小与 Cache 索引所需位数的关系。
-
地址结构划分:
-
页内偏移 (Page Offset):由页大小决定。题目页大小为 4KB,因此物理地址与虚拟地址的低 12 位(\(VA_{11} \sim VA_0\))是完全相同的,不需要经过地址转换。
-
Cache 查找字段:由块内地址和组号构成。题目块大小 64B(占 6 位),采用 8 路组相联,Cache 数据区 32KB。总组数 = 32KB / (8 × 64B) = 64 组(占 6 位)。因此,Cache 查找所需的总位数为 \(6 + 6 = 12\) 位。
-
核心考点:
因为 Cache 的组号 + 块内地址(共 12 位)刚好全部落在了页内偏移(12 位)的范围内。这意味着,在进行虚拟地址到物理地址转换(查 TLB/页表)的同时,CPU 可以直接提取虚拟地址的 \(VA_{11} \sim VA_6\) 作为 Cache 的组号去并发查找 Cache,大大提高了运行效率。